Bạn tải một mô hình AI về máy, bấm chạy, và nhận lại dòng báo lỗi "CUDA out of memory". Card đồ hoạ vẫn mạnh, chơi game vẫn mượt, vậy mà AI lại không chạy nổi. Nguyên nhân gần như luôn nằm ở một con số ít ai để ý khi mua card: dung lượng VRAM. Bài này giải thích VRAM là gì, vì sao AI "ngốn" VRAM hơn game nhiều, và cách tự tính xem máy mình chạy được mô hình nào.
VRAM là gì và nó nằm ở đâu
VRAM (Video RAM) là bộ nhớ riêng gắn trực tiếp trên bo mạch card đồ hoạ, nằm sát con chip GPU. Nó khác với RAM hệ thống (thanh DDR4/DDR5 cắm trên bo mạch chủ) ở hai điểm:
- Chỉ GPU dùng trực tiếp. Mọi dữ liệu GPU cần tính, từ texture trong game đến trọng số của mô hình AI, phải nằm trong VRAM thì GPU mới xử lý ở tốc độ tối đa.
- Băng thông cao hơn rất nhiều. VRAM đời mới dùng chuẩn GDDR6, GDDR6X, GDDR7, còn card trung tâm dữ liệu dùng HBM, được thiết kế để đẩy hàng trăm đến hàng nghìn GB dữ liệu mỗi giây.
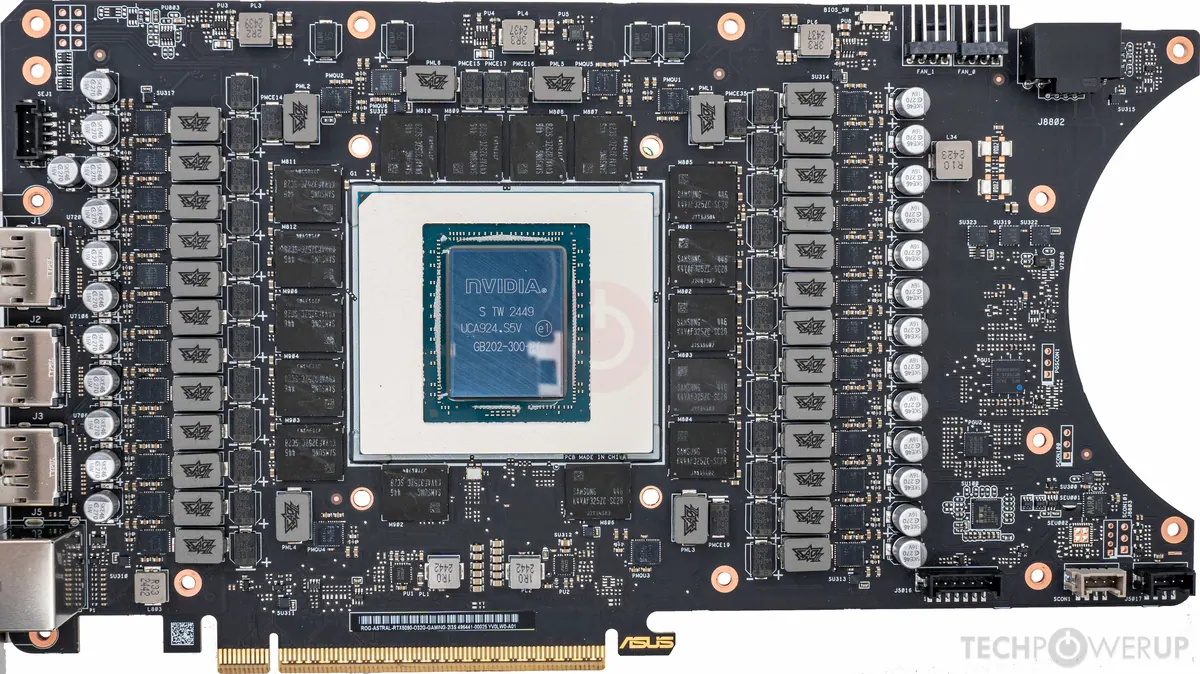
Nhìn bo mạch card đã tháo tản nhiệt, bạn sẽ thấy chip GPU lớn ở giữa và các chip nhớ nhỏ xếp vòng quanh. Mỗi chip nhớ là vài GB VRAM. Số chip và độ rộng bus quyết định cả dung lượng lẫn băng thông của card.
So sánh băng thông: vì sao không dùng RAM thường cho AI
Băng thông là lượng dữ liệu bộ nhớ có thể đọc/ghi mỗi giây. Với AI, đây là thông số quan trọng ngang dung lượng. Bảng dưới đây so sánh một số cấu hình phổ biến (số liệu theo thông số công bố của nhà sản xuất):
| Bộ nhớ | Dung lượng | Băng thông xấp xỉ |
|---|---|---|
| RAM DDR5-6000, 2 kênh (PC) | tuỳ máy | ~96 GB/s |
| RTX 4060 (GDDR6) | 8 GB | ~272 GB/s |
| RTX 3060 (GDDR6) | 12 GB | ~360 GB/s |
| RTX 4070 (GDDR6X) | 12 GB | ~504 GB/s |
| RTX 4090 (GDDR6X) | 24 GB | ~1.008 GB/s |
| RTX 5090 (GDDR7) | 32 GB | ~1.792 GB/s |
| H100 SXM (HBM3) | 80 GB | ~3.350 GB/s |
Khoảng cách giữa RAM hệ thống và VRAM thường là 3 đến 10 lần, chưa kể dữ liệu từ RAM muốn tới GPU còn phải đi qua khe PCIe. PCIe 4.0 x16 chỉ khoảng 32 GB/s mỗi chiều. Vì vậy khi mô hình không vừa VRAM và phải "tràn" ra RAM, tốc độ không giảm vài phần trăm mà có thể giảm hàng chục lần.
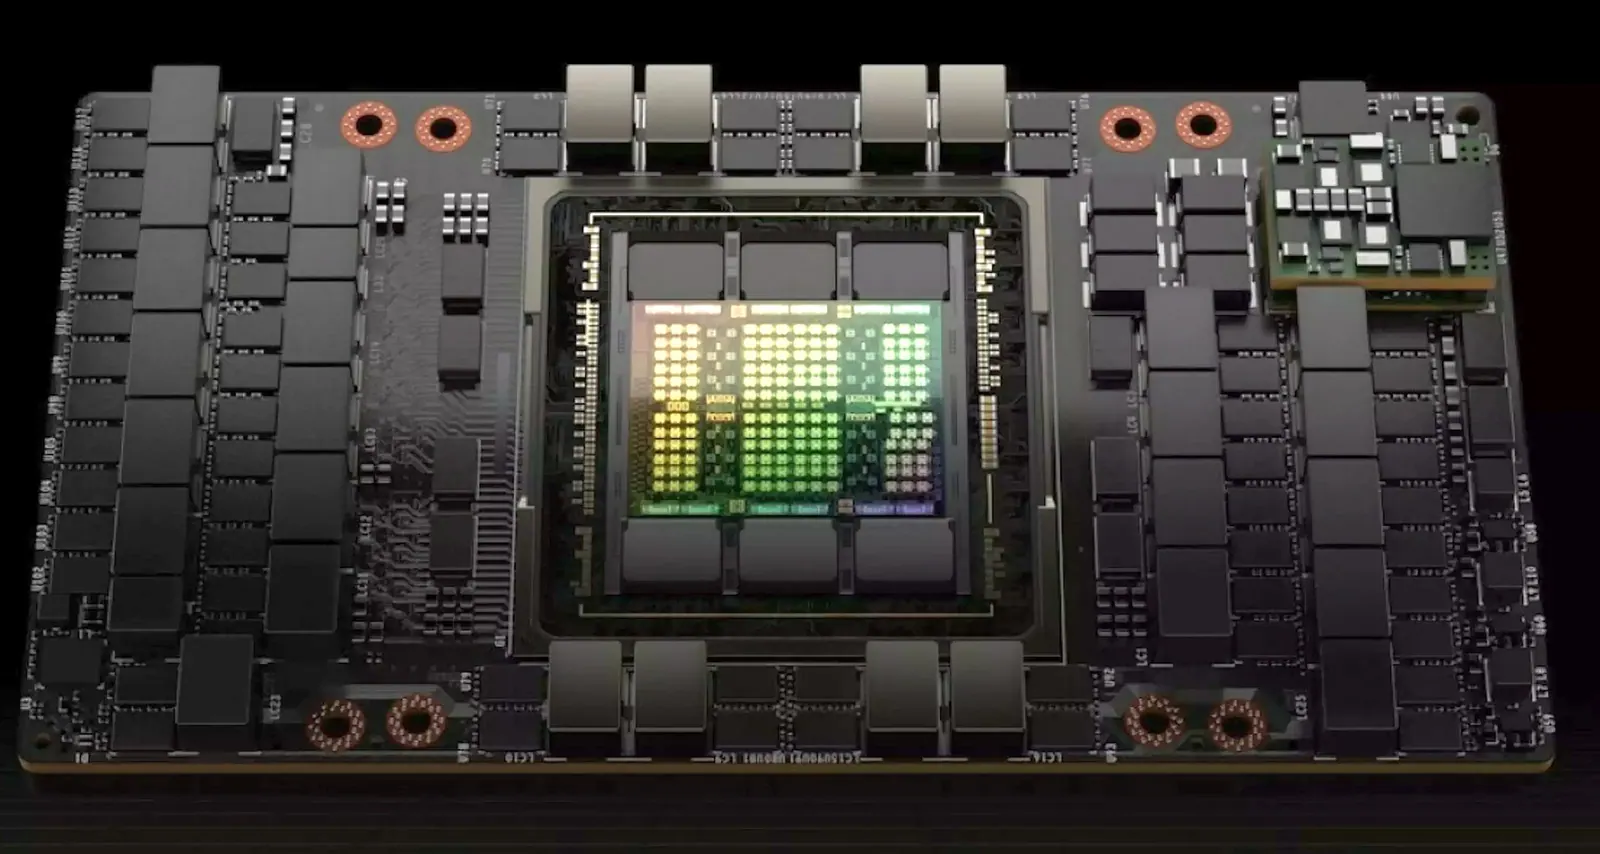
Card trung tâm dữ liệu như H100 đặt các chồng nhớ HBM ngay cạnh chip GPU trên cùng một đế. Đó là cách đạt băng thông vài TB/s, và cũng là lý do giá của chúng đắt hơn card chơi game rất nhiều.
Vì sao AI ngốn VRAM hơn game
Game cần VRAM cho texture, bộ đệm khung hình và hiệu ứng. Nếu thiếu, game vẫn chạy nhưng giật hoặc phải hạ chất lượng texture. AI thì khắt khe hơn: toàn bộ "bộ não" của mô hình phải nằm trong VRAM.
Mô hình AI về bản chất là một tập hợp khổng lồ các con số gọi là tham số (parameters, hay trọng số). Mô hình 7B nghĩa là có khoảng 7 tỷ tham số. Mỗi lần sinh ra một từ (token), GPU phải đọc gần như toàn bộ số tham số đó một lượt. Không có chuyện chỉ nạp phần cần dùng như game nạp texture theo màn chơi.
Cách ước lượng đơn giản nhất:
VRAM cho trọng số ≈ số tham số × số byte mỗi tham số
| Định dạng | Byte/tham số | Mô hình 7B | Mô hình 13B | Mô hình 70B |
|---|---|---|---|---|
| FP16 / BF16 (gốc) | 2 | ~14 GB | ~26 GB | ~140 GB |
| 8-bit (INT8/Q8) | 1 | ~7 GB | ~13 GB | ~70 GB |
| 4-bit (Q4) | ~0,5–0,6 | ~4–4,5 GB | ~7–8 GB | ~38–42 GB |
Đây mới chỉ là phần trọng số. Khi chạy thật còn cần thêm VRAM cho mấy thứ khác.
KV cache: phần ăn VRAM âm thầm
Khi trò chuyện với mô hình ngôn ngữ, nó phải nhớ toàn bộ đoạn hội thoại trước đó. Bộ nhớ này gọi là KV cache và tăng theo độ dài ngữ cảnh. Lấy ví dụ Llama 3 8B (32 lớp, 8 đầu KV, mỗi đầu 128 chiều, lưu ở FP16):
- Mỗi token tốn: 2 × 32 × 8 × 128 × 2 byte = 131.072 byte, tức 128 KB.
- Ngữ cảnh 8.000 token: khoảng 1 GB.
- Ngữ cảnh 32.000 token: khoảng 4 GB.
Nghĩa là cùng một mô hình 4-bit nặng chừng 5 GB, nếu bạn mở ngữ cảnh dài thì 8 GB VRAM đã bắt đầu chật. Cộng thêm vài trăm MB cho thư viện CUDA và bộ đệm tính toán, rồi phần màn hình Windows đang chiếm, bạn sẽ hiểu vì sao con số "12 GB" hay được khuyên.
Lấy dung lượng file mô hình (định dạng đã lượng tử hoá) cộng thêm 1–2 GB cho ngữ cảnh và hệ thống. Nếu tổng vượt VRAM của card, mô hình sẽ chạy chậm hẳn hoặc không chạy được.
Tạo ảnh AI cũng cần nhiều VRAM
Không chỉ chatbot, các mô hình tạo ảnh cũng tuân theo cùng nguyên tắc:
- Stable Diffusion 1.5 (khoảng 1 tỷ tham số): chạy thoải mái trên card 6–8 GB.
- SDXL (khoảng 3,5 tỷ tham số cho cả hệ thống): file FP16 nặng gần 7 GB. Chạy được trên 8 GB nếu bật các chế độ tiết kiệm, nhưng 12 GB mới dễ chịu khi thêm ControlNet, LoRA hoặc ảnh độ phân giải cao.
- FLUX.1 (khoảng 12 tỷ tham số cho phần chính): bản FP16 cần trên 20 GB, phải dùng bản FP8 hay lượng tử hoá mới vừa các card 12–16 GB.
Tạo ảnh còn tốn VRAM theo độ phân giải: ảnh càng lớn, bộ đệm trung gian càng phình. Tạo video AI thì nặng hơn nhiều vì phải xử lý cùng lúc hàng chục khung hình.
Vì sao mốc 12 GB được xem là ngưỡng
Ghép các con số trên lại, ta thấy:
- 8 GB: chạy được mô hình ngôn ngữ 7–8B ở dạng 4-bit với ngữ cảnh ngắn, SDXL ở chế độ tiết kiệm. Hơi sát, dễ báo lỗi khi mở rộng.
- 12 GB: chạy mượt mô hình 7–8B ở 4-bit hoặc 8-bit, thử được mô hình 13–14B ở 4-bit, SDXL kèm LoRA thoải mái, FLUX bản lượng tử hoá. Đây là mức "dùng được thật" cho người mới.
- 16 GB: có dư địa cho ngữ cảnh dài, mô hình 14B ở 8-bit, tinh chỉnh nhẹ bằng QLoRA.
- 24 GB trở lên: chạy mô hình 30B ở 4-bit, FLUX bản đầy đủ hơn, thử nghiệm nghiêm túc.
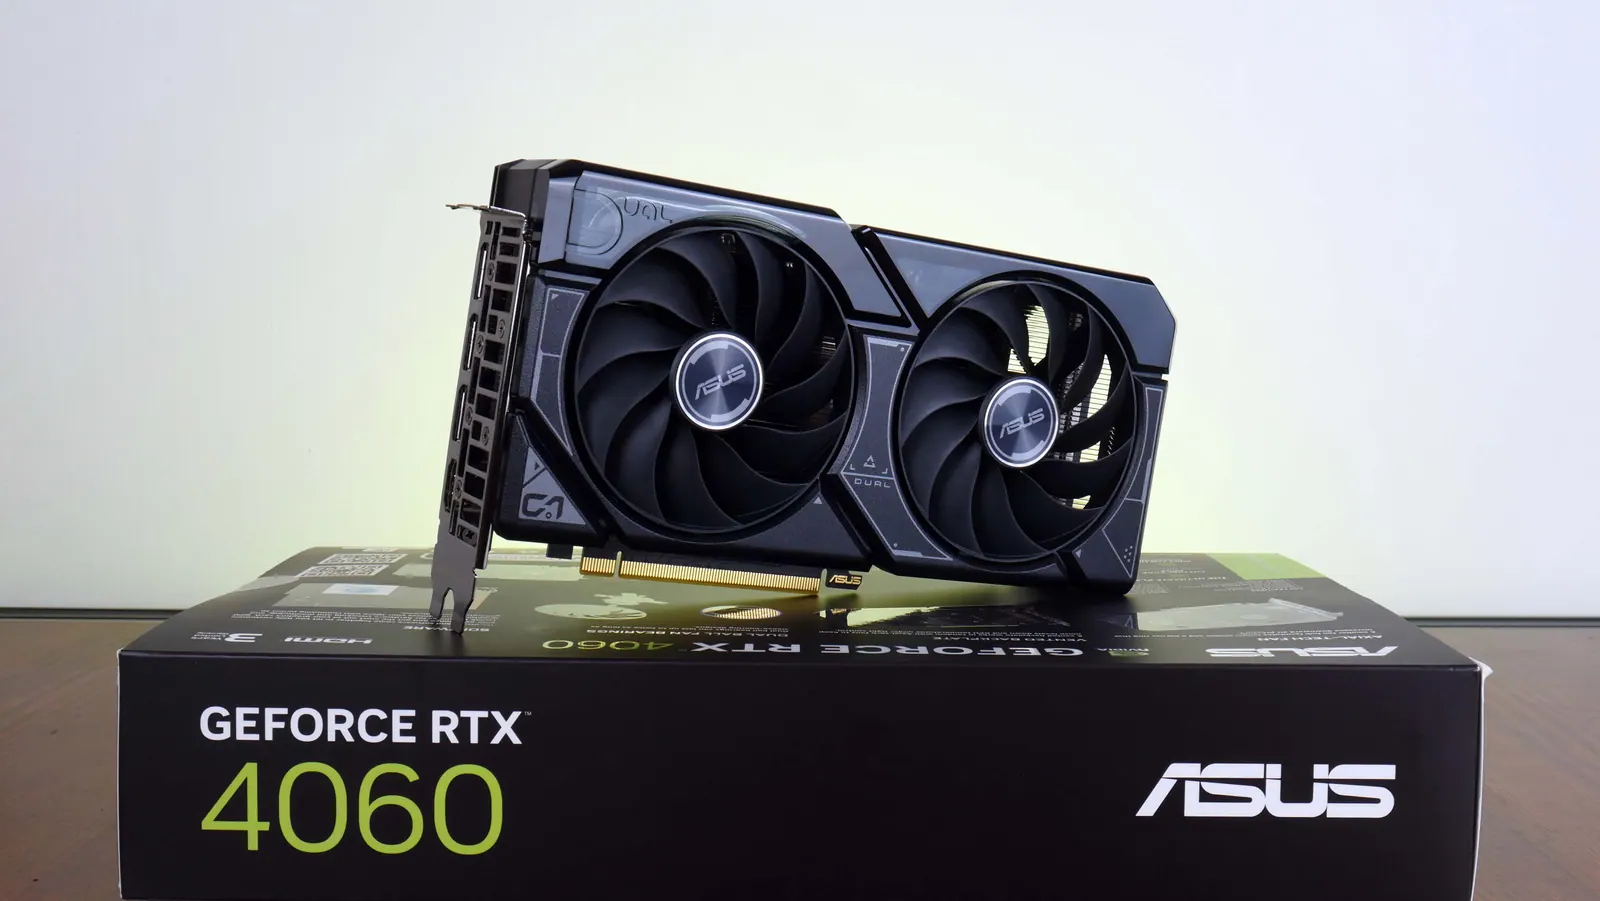
Một nghịch lý hay gặp: RTX 4060 (8 GB) nhanh hơn RTX 3060 (12 GB) khi chơi game, nhưng với AI thì RTX 3060 12 GB lại chạy được nhiều mô hình hơn. Với AI, vừa VRAM quan trọng hơn chip nhanh. Một mô hình nằm gọn trong VRAM trên card yếu hơn vẫn nhanh hơn nhiều so với mô hình bị tràn ra RAM trên card mạnh hơn.
Băng thông quyết định tốc độ sinh chữ
Dung lượng quyết định chạy được hay không, còn băng thông quyết định chạy nhanh hay chậm. Khi sinh từng token, mô hình ngôn ngữ bị giới hạn bởi tốc độ đọc trọng số từ bộ nhớ nhiều hơn là tốc độ tính toán. Có một cách ước lượng trần tốc độ:
Token/giây tối đa ≈ băng thông bộ nhớ ÷ dung lượng trọng số
Ví dụ mô hình 8B ở 4-bit nặng khoảng 4,5 GB:
- Trên RTX 3060 (~360 GB/s): trần khoảng 80 token/giây.
- Trên RTX 4090 (~1.008 GB/s): trần khoảng 220 token/giây.
- Chạy bằng RAM DDR5 2 kênh (~96 GB/s): trần khoảng 20 token/giây, thực tế thấp hơn.
Con số thực tế luôn thấp hơn trần vì còn chi phí tính toán và phần mềm, nhưng tỷ lệ giữa các cấu hình thì khá sát. Đó là lý do card có bus nhớ rộng và chuẩn nhớ mới (GDDR6X, GDDR7, HBM) được dân AI săn đón.
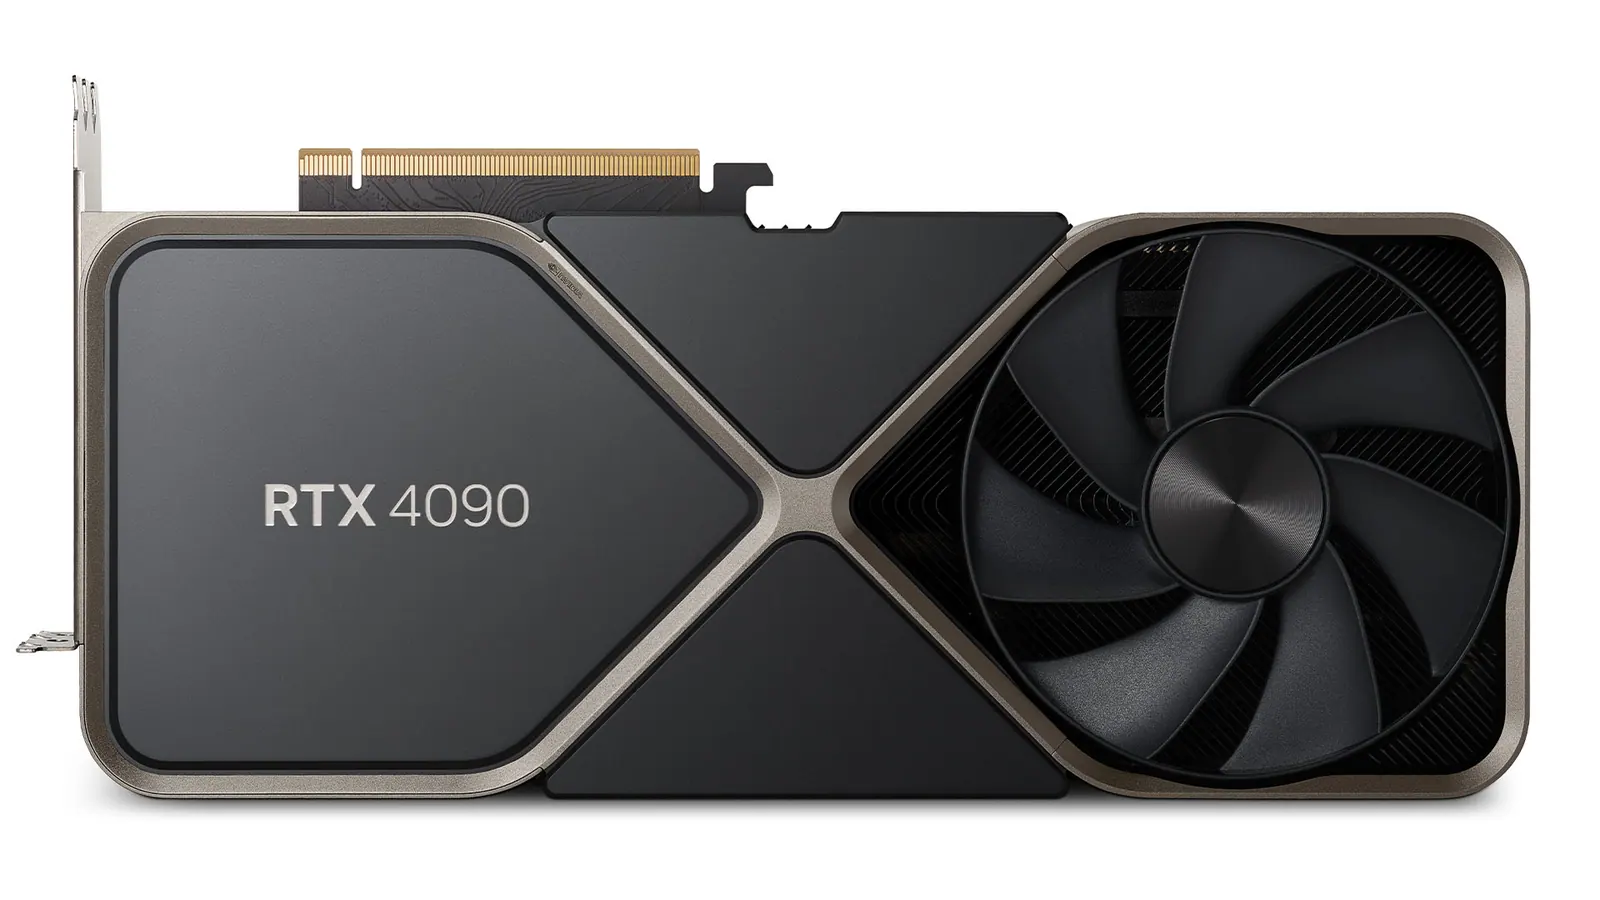
Cách kiểm tra VRAM và theo dõi khi chạy AI
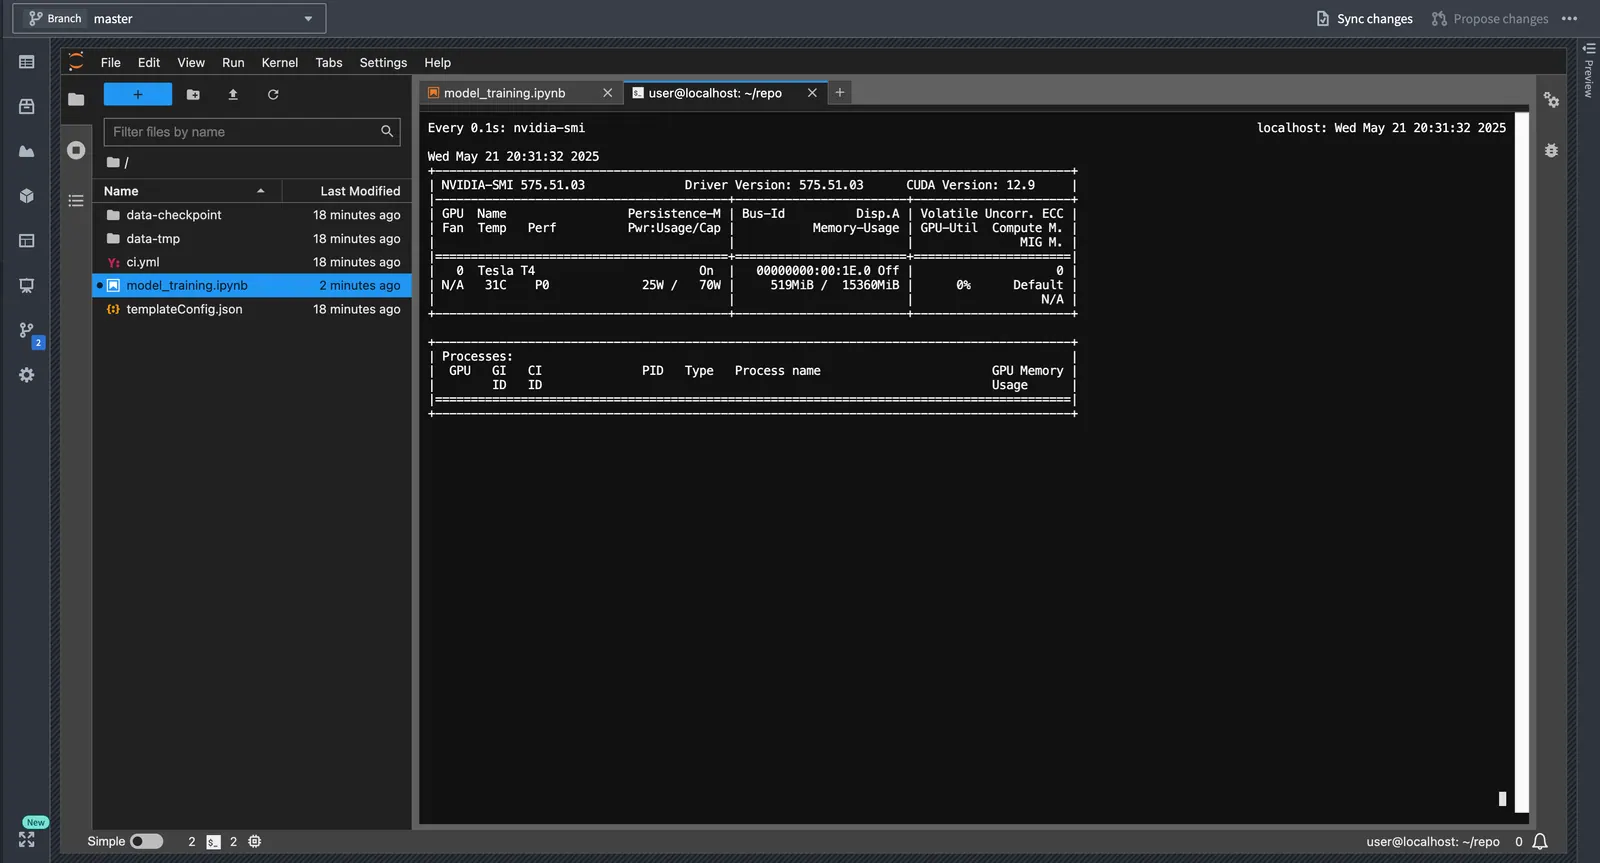
Với card NVIDIA, lệnh nvidia-smi cho biết tổng VRAM, lượng đang dùng và tiến trình nào chiếm:
# Xem tổng quan VRAM và tiến trình đang dùng GPU
nvidia-smi

# Cập nhật liên tục mỗi giây trong lúc chạy mô hình
nvidia-smi -l 1

# Chỉ in dung lượng đã dùng / tổng
nvidia-smi --query-gpu=name,memory.used,memory.total --format=csv
Nếu chạy mô hình bằng Ollama, lệnh ollama ps cho biết mô hình đang nằm hoàn toàn trên GPU hay bị chia một phần sang CPU:
ollama ps
# Cột PROCESSOR: "100% GPU" là tốt nhất;
# "40%/60% CPU/GPU" nghĩa là đã tràn ra RAM, tốc độ sẽ giảm mạnh
Trên Windows, mở Task Manager, tab Performance, chọn GPU để xem "Dedicated GPU memory" (VRAM thật) và "Shared GPU memory" (RAM hệ thống mượn tạm, chậm hơn nhiều).
Windows có thể báo GPU có thêm hàng chục GB "bộ nhớ chia sẻ". Đó là RAM hệ thống, đi qua PCIe nên chậm hơn VRAM nhiều lần. Driver NVIDIA trên Windows có thể tự đẩy dữ liệu tràn sang vùng này thay vì báo lỗi, nên mô hình vẫn "chạy" nhưng chậm như rùa. Khi tốc độ bất ngờ tụt mạnh, hãy kiểm tra xem VRAM thật đã đầy chưa.
Sai lầm hay gặp và mẹo tiết kiệm VRAM
Những sai lầm phổ biến khi chọn card hoặc chạy AI tại nhà:
- Chỉ nhìn tên dòng card. Cùng một tên có thể có nhiều bản VRAM khác nhau, ví dụ RTX 4060 Ti có bản 8 GB và 16 GB. Với AI, bản 16 GB đáng tiền hơn hẳn.
- Tải bản FP16 gốc trong khi card chỉ 8–12 GB. Hầu hết người dùng cá nhân nên dùng bản lượng tử hoá 4-bit hoặc 5-bit (định dạng GGUF, AWQ, EXL2...). Chất lượng giảm rất ít so với mức tiết kiệm VRAM.
- Đặt ngữ cảnh quá dài. Đặt 128K token cho vui sẽ ăn hết VRAM vào KV cache. Hãy để mức vừa đủ dùng.
- Quên các ứng dụng khác đang chiếm VRAM. Trình duyệt, game, phần mềm dựng video đều giữ VRAM. Tắt bớt trước khi chạy mô hình lớn.
Huấn luyện đầy đủ tốn VRAM gấp nhiều lần chạy suy luận: với cách huấn luyện mixed precision dùng Adam, mỗi tham số cần khoảng 16 byte cho trọng số, gradient và trạng thái bộ tối ưu, tức hơn 100 GB cho mô hình 7B. Người dùng cá nhân nên dùng LoRA hoặc QLoRA, chỉ huấn luyện một phần nhỏ tham số. Khi đó card 12–16 GB đã đủ để tinh chỉnh mô hình 7–8B.
Checklist trước khi mua card để chạy AI:
- [ ]Xác định nhu cầu chính: chatbot cục bộ, tạo ảnh, hay tinh chỉnh mô hình
- [ ]Ưu tiên dung lượng VRAM trước, rồi mới tới tốc độ chip
- [ ]Chọn tối thiểu 12 GB, 16 GB nếu muốn dùng lâu dài
- [ ]Kiểm tra băng thông bộ nhớ (độ rộng bus, chuẩn GDDR)
- [ ]Ưu tiên card NVIDIA nếu muốn ít rắc rối phần mềm, vì phần lớn công cụ AI hỗ trợ CUDA tốt nhất
Tóm tắt nhanh
- VRAM là bộ nhớ riêng của card đồ hoạ, nhanh hơn RAM hệ thống nhiều lần.
- Mô hình AI phải nằm trọn trong VRAM mới chạy nhanh; tràn ra RAM có thể chậm đi hàng chục lần.
- Ước lượng: VRAM ≈ số tham số × byte mỗi tham số, cộng 1–2 GB cho ngữ cảnh và hệ thống.
- 12 GB là ngưỡng thực tế để chạy thoải mái mô hình 7–8B, SDXL và FLUX bản lượng tử hoá.
- Dung lượng quyết định chạy được hay không, băng thông quyết định chạy nhanh hay chậm.
Câu hỏi thường gặp
Card 8 GB có chạy được AI không?
Có, nhưng hạn chế. Bạn chạy được mô hình ngôn ngữ 7–8B ở dạng 4-bit với ngữ cảnh ngắn và Stable Diffusion ở mức cơ bản. Khi cần mô hình lớn hơn hoặc ngữ cảnh dài, 8 GB sẽ nhanh chóng không đủ.
Có thể cộng VRAM của hai card lại không?
Với chạy mô hình ngôn ngữ thì được. Các công cụ như llama.cpp, vLLM có thể chia các lớp của mô hình sang nhiều GPU. Tuy vậy tốc độ không cộng tuyến tính, và tạo ảnh thường khó tận dụng nhiều card hơn.
Máy Mac chip Apple Silicon thì sao?
Mac dùng bộ nhớ hợp nhất (unified memory): CPU và GPU dùng chung một vùng RAM có băng thông cao. Nhờ vậy Mac có nhiều RAM chạy được mô hình lớn mà card rời phổ thông không chứa nổi, dù tốc độ sinh chữ thường thấp hơn card NVIDIA cao cấp.
Nên chọn card cũ nhiều VRAM hay card mới ít VRAM?
Nếu mục đích chính là AI, thường nên chọn card nhiều VRAM hơn, miễn là vẫn được driver và CUDA hỗ trợ. Một mô hình vừa khít VRAM trên card cũ vẫn chạy nhanh hơn mô hình bị tràn bộ nhớ trên card mới.