Bạn muốn có một trợ lý AI trả lời ngay trên máy tính của mình: không gửi dữ liệu lên máy chủ nào, không cần mạng, không lo hết lượt dùng miễn phí. Điều đó hoàn toàn làm được, nhưng câu hỏi đầu tiên ai cũng gặp là: máy mình có chạy nổi không, và nếu nâng cấp thì nên dồn tiền vào đâu? Câu trả lời ngắn gọn: bộ nhớ quyết định gần như tất cả, còn CPU mạnh hay yếu lại ít quan trọng hơn bạn nghĩ.
Chạy AI "cục bộ" thực chất là làm gì?
Các chatbot như ChatGPT hay Claude chạy trên những cụm máy chủ khổng lồ. Khi chạy AI cục bộ (local AI), bạn tải về một mô hình ngôn ngữ mã nguồn mở (open-weight model) như Llama, Qwen, Gemma, Mistral hay DeepSeek, rồi dùng một phần mềm để chạy nó ngay trên máy.
Mô hình về bản chất là một file rất lớn chứa hàng tỷ con số gọi là tham số (parameter). Mỗi khi AI sinh ra một từ, máy phải đọc qua gần như toàn bộ đống tham số đó. Từ đây suy ra hai điều cốt lõi:
- Toàn bộ mô hình phải nằm vừa trong bộ nhớ (lý tưởng là VRAM của card đồ hoạ).
- Tốc độ trả lời phụ thuộc vào việc bộ nhớ đọc dữ liệu nhanh đến đâu, tức là băng thông bộ nhớ.
Các phần mềm phổ biến để làm việc này gồm Ollama (chạy bằng dòng lệnh, rất gọn), LM Studio (giao diện đồ hoạ, hợp người mới) và llama.cpp (lõi mà nhiều công cụ khác dựa vào). Chúng đều dùng định dạng mô hình GGUF đã được nén sẵn.
Tính nhanh: mô hình nặng bao nhiêu GB?
Tên mô hình thường đi kèm số tham số: 8B là 8 tỷ, 70B là 70 tỷ. Ở dạng gốc, mỗi tham số chiếm 2 byte (FP16), nên một mô hình 8B nặng khoảng 16 GB, còn 70B lên tới khoảng 140 GB. Quá nặng với máy cá nhân.
Giải pháp là lượng tử hoá (quantization): giảm độ chính xác của từng con số từ 16 bit xuống còn khoảng 4–8 bit. Mức phổ biến nhất là Q4_K_M, trung bình gần 5 bit mỗi tham số, giúp mô hình nhẹ đi khoảng 3 lần mà chất lượng giảm không đáng kể với đa số tác vụ.
Công thức ước lượng:
Dung lượng (GB) ≈ số tỷ tham số × số bit / 8, cộng thêm 1–2 GB cho bộ đệm ngữ cảnh.
| Cỡ mô hình | Dạng gốc FP16 | Q8 (8 bit) | Q4_K_M (~4,8 bit) | Bộ nhớ nên có |
|---|---|---|---|---|
| 3–4B | 6–8 GB | 3–4 GB | 2–2,5 GB | 4–6 GB |
| 7–8B | 14–16 GB | 7–8,5 GB | 4,5–5 GB | 8 GB |
| 12–14B | 24–28 GB | 13–15 GB | 7,5–9 GB | 12 GB |
| 30–32B | 60–64 GB | 32–34 GB | 18–20 GB | 24 GB |
| 70B | ~140 GB | ~75 GB | ~40–43 GB | 48 GB trở lên |
Ví dụ thực tế: bản Llama 3.1 8B mặc định trên Ollama nặng khoảng 4,9 GB, bản 70B khoảng 43 GB, khớp với bảng trên.
Ngoài bản thân mô hình, AI còn cần chỗ để nhớ cuộc trò chuyện. Phần này tăng theo độ dài ngữ cảnh: dán vào một tài liệu dài vài chục nghìn token có thể ngốn thêm vài GB. Vì vậy luôn chừa dư bộ nhớ chứ đừng chọn mô hình vừa khít.
GPU và VRAM: thứ quan trọng nhất
Card đồ hoạ (GPU) chạy AI nhanh vượt trội nhờ hai yếu tố: hàng nghìn nhân tính toán song song và bộ nhớ VRAM có băng thông rất cao. Khi mô hình nằm trọn trong VRAM, tốc độ sinh chữ thường đủ nhanh để đọc thoải mái.
Điều cần nhớ là dung lượng VRAM quan trọng hơn đời card. Một card cũ hơn nhưng nhiều VRAM thường hữu ích hơn card mới nhưng ít VRAM, vì nó chứa được mô hình lớn hơn.
| Dung lượng VRAM | Ví dụ card | Chạy thoải mái (Q4) |
|---|---|---|
| 8 GB | RTX 3060 Ti, RTX 4060 | Mô hình 7–8B, ngữ cảnh vừa phải |
| 12 GB | RTX 3060 12GB, RTX 4070 | Mô hình 12–14B |
| 16 GB | RTX 4060 Ti 16GB, RTX 4080 | Mô hình 14B với ngữ cảnh dài, 20B+ ở mức nén sâu |
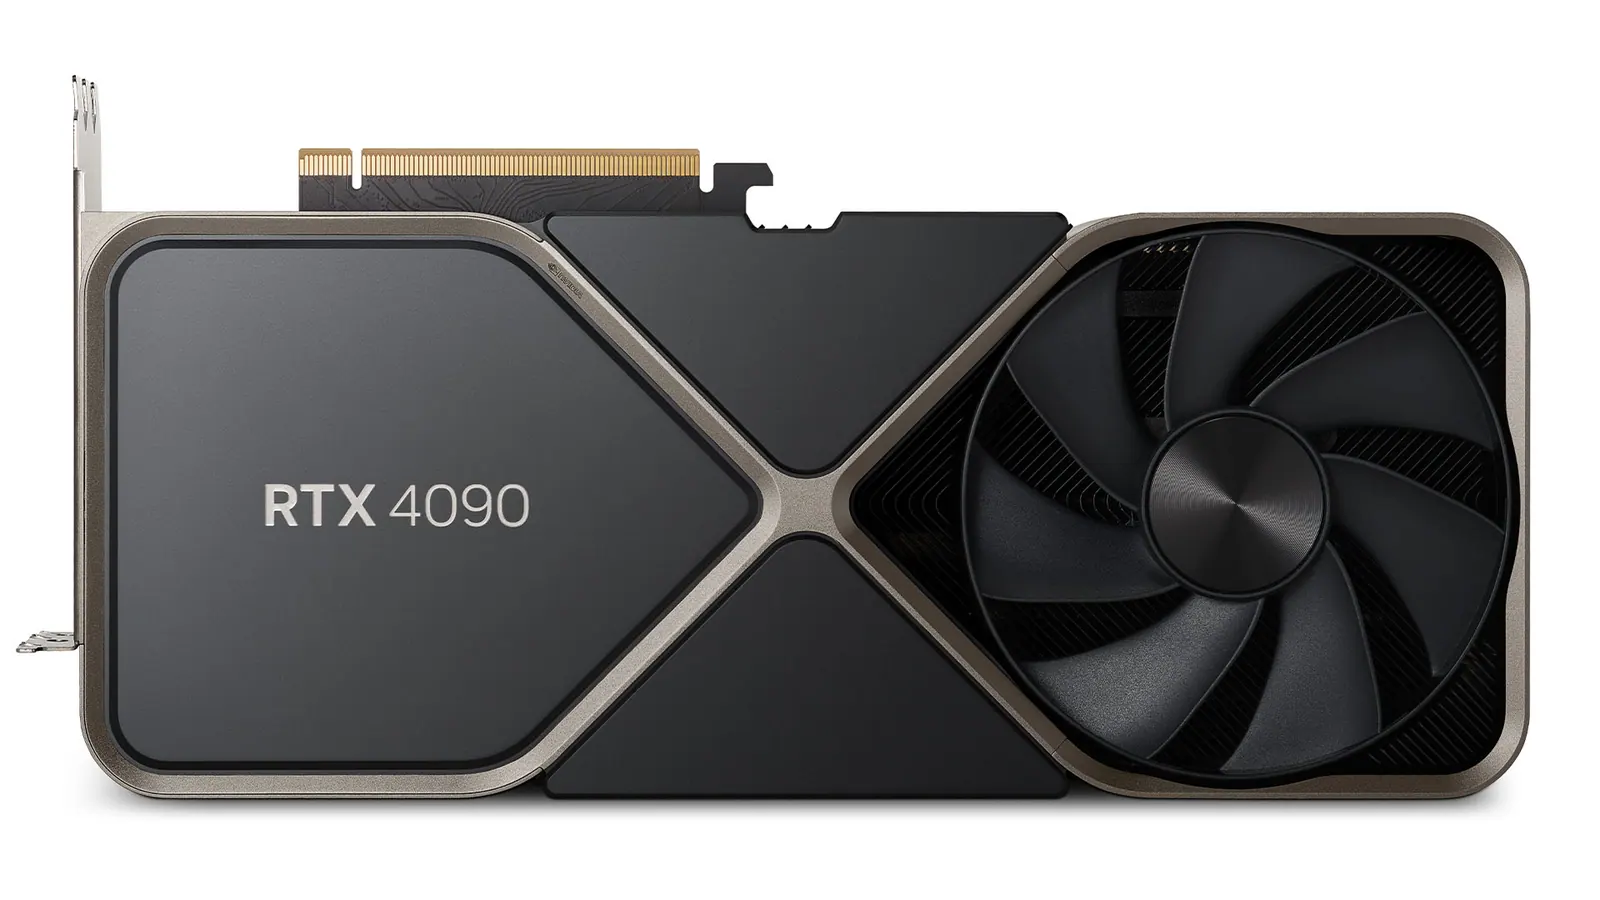
| 24 GB | RTX 3090, RTX 4090 | Mô hình 30–32B |
| 32 GB | RTX 5090 | Mô hình 32B với ngữ cảnh dài |
Card NVIDIA được hỗ trợ tốt nhất nhờ nền tảng CUDA. Card AMD và Intel vẫn dùng được qua ROCm hoặc Vulkan, nhưng mức độ hỗ trợ tuỳ phần mềm và hệ điều hành, nên hãy kiểm tra trước khi mua.
Nếu mô hình lớn hơn VRAM, phần mềm sẽ đẩy một phần sang RAM hệ thống và để CPU xử lý. Máy vẫn chạy, nhưng tốc độ có thể tụt từ vài chục từ mỗi giây xuống chỉ còn vài từ, vì RAM thường chậm hơn VRAM nhiều lần. Đây là lỗi phổ biến nhất khi người dùng thấy "AI chạy như rùa".
Vì sao băng thông bộ nhớ quyết định tốc độ?
Để sinh ra mỗi token (khoảng 3/4 một từ tiếng Anh, tiếng Việt thường tốn hơn), máy gần như phải đọc toàn bộ mô hình một lượt. Vì thế tốc độ tối đa có thể ước lượng thô:
Số token mỗi giây (tối đa) ≈ băng thông bộ nhớ ÷ dung lượng mô hình
Thực tế thường đạt khoảng một nửa đến hai phần ba con số này, nhưng nó cho thấy rõ thứ bậc:
| Loại bộ nhớ | Băng thông xấp xỉ | Trần lý thuyết với mô hình 5 GB |
|---|---|---|
| RAM DDR5 kênh đôi (PC phổ thông) | 80–100 GB/s | 16–20 token/s |
| Apple M4 Pro | 273 GB/s | ~55 token/s |
| RTX 3060 12GB | 360 GB/s | ~70 token/s |
| Apple M4 Max (bản cao) | 546 GB/s | ~110 token/s |
| RTX 4090 | ~1.000 GB/s | ~200 token/s |
Đây cũng là lý do CPU mạnh không cứu được tốc độ: dù có bao nhiêu nhân, CPU vẫn phải chờ dữ liệu từ RAM. Vai trò của CPU chủ yếu là xử lý phần tràn và giữ hệ thống mượt.
RAM hệ thống: cần bao nhiêu?
Kể cả khi có GPU, RAM vẫn quan trọng vì mô hình được nạp từ ổ đĩa qua RAM trước khi lên VRAM, và trình duyệt, phần mềm khác vẫn cần chỗ.
- 16 GB: mức tối thiểu nếu có GPU rời và chỉ chạy mô hình 7–8B.
- 32 GB: mức khuyên dùng cho đa số người, đủ để thử mô hình 14B kể cả khi tràn một phần sang RAM.
- 64 GB trở lên: khi muốn chạy mô hình 30B+ chủ yếu bằng CPU, hoặc chạy song song nhiều mô hình.
Nếu máy không có GPU rời, RAM chính là nơi chứa mô hình. Lúc đó hãy chọn mô hình nhỏ (3–8B) và đảm bảo RAM chạy kênh đôi (hai thanh thay vì một), vì một thanh RAM duy nhất làm băng thông giảm gần một nửa.
Trên Windows, mở Task Manager, tab Performance, mục Memory để xem số khe đang dùng. Hai thanh cắm đúng khe theo hướng dẫn của bo mạch chủ (thường là khe thứ 2 và 4) sẽ chạy kênh đôi.
Mac Apple Silicon: lựa chọn đặc biệt
Mac dùng chip M-series có bộ nhớ hợp nhất (unified memory): CPU và GPU dùng chung một vùng RAM. Nghĩa là một chiếc Mac 64 GB có thể dành phần lớn bộ nhớ đó cho mô hình AI, điều mà muốn làm trên PC phải dùng hai, ba card đồ hoạ cao cấp.
Đổi lại, băng thông của Mac (nhất là bản chip thường và Pro) thấp hơn card NVIDIA cao cấp, nên với cùng một mô hình nhỏ, PC có RTX thường sinh chữ nhanh hơn. Mac mạnh ở chỗ chạy được mô hình lớn trong một máy gọn, êm, ít điện.
Lưu ý: macOS không cho GPU dùng 100% bộ nhớ, mặc định chỉ khoảng hai phần ba đến ba phần tư tổng RAM. Một máy 16 GB vì vậy thực tế chỉ thoải mái với mô hình 7–8B. Nếu mua Mac để chạy AI, RAM là thứ phải chọn đúng ngay từ đầu vì không nâng cấp được về sau.
SSD: không làm AI nhanh hơn, nhưng đừng xem nhẹ
Ổ cứng chỉ dùng lúc nạp mô hình. Khi mô hình đã vào bộ nhớ, SSD gần như không ảnh hưởng tới tốc độ trả lời. Tuy vậy, nó tác động tới trải nghiệm theo hai cách:
- Tốc độ nạp: SSD NVMe đọc vài GB/s nên nạp mô hình 5 GB chỉ mất vài giây; ổ HDD có thể mất cả phút.
- Dung lượng: mỗi mô hình nặng từ vài GB đến hơn 40 GB, mà người dùng thường thích thử nhiều mô hình. Một thư viện nhỏ vài mô hình đã chiếm cả trăm GB.
Gợi ý: dành riêng ít nhất 500 GB, tốt nhất 1 TB SSD NVMe cho mô hình. Ollama và LM Studio đều cho phép đổi thư mục lưu mô hình sang ổ khác nếu ổ hệ thống đầy.
Cấu hình gợi ý theo nhu cầu
| Nhu cầu | GPU / Bộ nhớ | RAM | SSD | Mô hình phù hợp |
|---|---|---|---|---|
| Thử cho biết, laptop sẵn có | Không cần GPU rời | 16 GB kênh đôi | 256 GB trống | 3–4B (Q4) |
| Dùng hằng ngày: viết, tóm tắt, dịch | GPU 8–12 GB VRAM | 32 GB | 512 GB–1 TB | 7–14B |
| Lập trình, phân tích tài liệu dài | GPU 16–24 GB VRAM | 32–64 GB | 1 TB | 14–32B |
| Muốn chạy mô hình rất lớn | 2 GPU 24 GB hoặc Mac 64–128 GB | 64–128 GB | 2 TB | 70B |
Để thử nhanh với Ollama sau khi cài đặt, chỉ cần vài lệnh:
# Tải và chạy mô hình 8B (khoảng 5 GB)
ollama run llama3.1:8b

# Xem các mô hình đã tải và dung lượng
ollama list

# Xem mô hình đang chạy trên GPU hay CPU
ollama ps
Lệnh ollama ps rất hữu ích: nếu cột PROCESSOR hiện "100% GPU" là mô hình nằm gọn trong VRAM; nếu hiện tỉ lệ chia giữa CPU và GPU nghĩa là đã tràn và bạn nên chọn bản nhỏ hơn. Sau lần tải đầu tiên, mọi thứ chạy hoàn toàn không cần Internet.
Checklist trước khi nâng cấp:
- [ ]Xác định cỡ mô hình muốn chạy (8B, 14B hay 32B)
- [ ]Nhân với khoảng 0,6 GB mỗi tỷ tham số rồi cộng 2 GB để ra VRAM cần thiết
- [ ]Ưu tiên card nhiều VRAM hơn card đời mới
- [ ]Đảm bảo RAM chạy kênh đôi, tối thiểu 32 GB
- [ ]Chừa ít nhất 500 GB SSD NVMe cho thư viện mô hình
Tóm tắt nhanh
- Mô hình AI phải nằm vừa trong bộ nhớ; VRAM là nơi lý tưởng nhất.
- Ở mức nén Q4, mỗi tỷ tham số cần khoảng 0,6 GB, cộng thêm phần cho ngữ cảnh.
- Tốc độ trả lời phụ thuộc băng thông bộ nhớ, không phải sức mạnh CPU.
- Mac Apple Silicon chạy được mô hình lớn nhờ bộ nhớ hợp nhất nhưng sinh chữ chậm hơn GPU cao cấp.
- SSD chỉ ảnh hưởng thời gian nạp mô hình; hãy chọn NVMe và chừa đủ dung lượng.
Câu hỏi thường gặp
Máy không có card rời có chạy AI được không?
Được. Với RAM 16 GB kênh đôi, các mô hình 3–4B chạy khá ổn và 7–8B vẫn dùng được nhưng chậm hơn. Đây là cách tốt để thử trước khi quyết định nâng cấp.
AI chạy offline có thông minh bằng ChatGPT không?
Mô hình 7–14B chạy tại nhà làm tốt các việc như tóm tắt, viết nháp, dịch, giải thích code đơn giản, nhưng thường kém các mô hình thương mại lớn ở suy luận phức tạp. Mô hình 32B–70B thu hẹp khoảng cách đáng kể nhưng đòi hỏi phần cứng mạnh hơn nhiều.
Chạy AI offline có an toàn dữ liệu hơn không?
Có, vì nội dung bạn nhập không rời khỏi máy. Chỉ cần tải mô hình từ nguồn chính thống (thư viện của Ollama, Hugging Face) và chú ý các tiện ích bổ sung có kết nối mạng hay không.
Nên chọn mức nén Q4 hay Q8?
Q4_K_M là điểm cân bằng tốt cho đa số người. Nếu VRAM còn dư, Q5 hoặc Q8 cho chất lượng nhỉnh hơn một chút. Ngược lại, chọn mô hình lớn hơn ở Q4 thường đáng giá hơn chọn mô hình nhỏ ở Q8.