Một CPU desktop đời mới chạy hơn 4 tỷ nhịp mỗi giây, mỗi nhịp có thể xử lý vài lệnh cùng lúc. Vậy mà mỗi lần phải lấy một mẩu dữ liệu từ RAM, nó có thể phải đứng chờ hơn 300 nhịp, tức là gần như không làm được gì trong khoảng đó. Bài này giải thích tận gốc vì sao RAM chậm hơn cache nhiều đến vậy, vì sao các kỹ sư không đơn giản làm cả RAM bằng loại bộ nhớ nhanh, và điều đó ảnh hưởng thế nào tới code bạn viết hằng ngày.
Con số thật: cache và RAM chênh nhau bao nhiêu?
Độ trễ (latency) là thời gian từ lúc lõi CPU hỏi một địa chỉ cho tới khi dữ liệu về tới nơi. Số liệu dưới đây là mức điển hình trên CPU desktop vài năm gần đây, chạy quanh 4–5 GHz. Mỗi đời chip lệch đi một chút, nhưng tỉ lệ giữa các tầng thì gần như không đổi.
| Tầng bộ nhớ | Dung lượng điển hình | Độ trễ xấp xỉ | Quy ra nhịp ở 4 GHz |
|---|---|---|---|
| Thanh ghi | vài trăm byte | dưới 0,3 ns | 0–1 nhịp |
| Cache L1 | 32–64 KB mỗi lõi | ~1 ns | ~4–5 nhịp |
| Cache L2 | 1–2 MB mỗi lõi | ~3–4 ns | ~12–16 nhịp |
| Cache L3 | vài chục MB dùng chung | ~10–12 ns | ~40–50 nhịp |
| RAM (DDR4/DDR5) | 16–64 GB | ~70–100 ns | ~300–400 nhịp |
Từ L1 tới RAM chênh nhau khoảng 80 lần. Đáng chú ý là chênh lệch này gần như không thu hẹp qua các năm. Băng thông RAM tăng rất nhanh, từ DDR3 lên DDR5 gấp mấy lần, nhưng độ trễ tính bằng nano giây thì giữ quanh mức 10–15 ns cho riêng con chip DRAM và 70–100 ns cho cả hành trình. Trong khi đó CPU ngày càng nhanh, nên số nhịp phải chờ ngày càng nhiều.
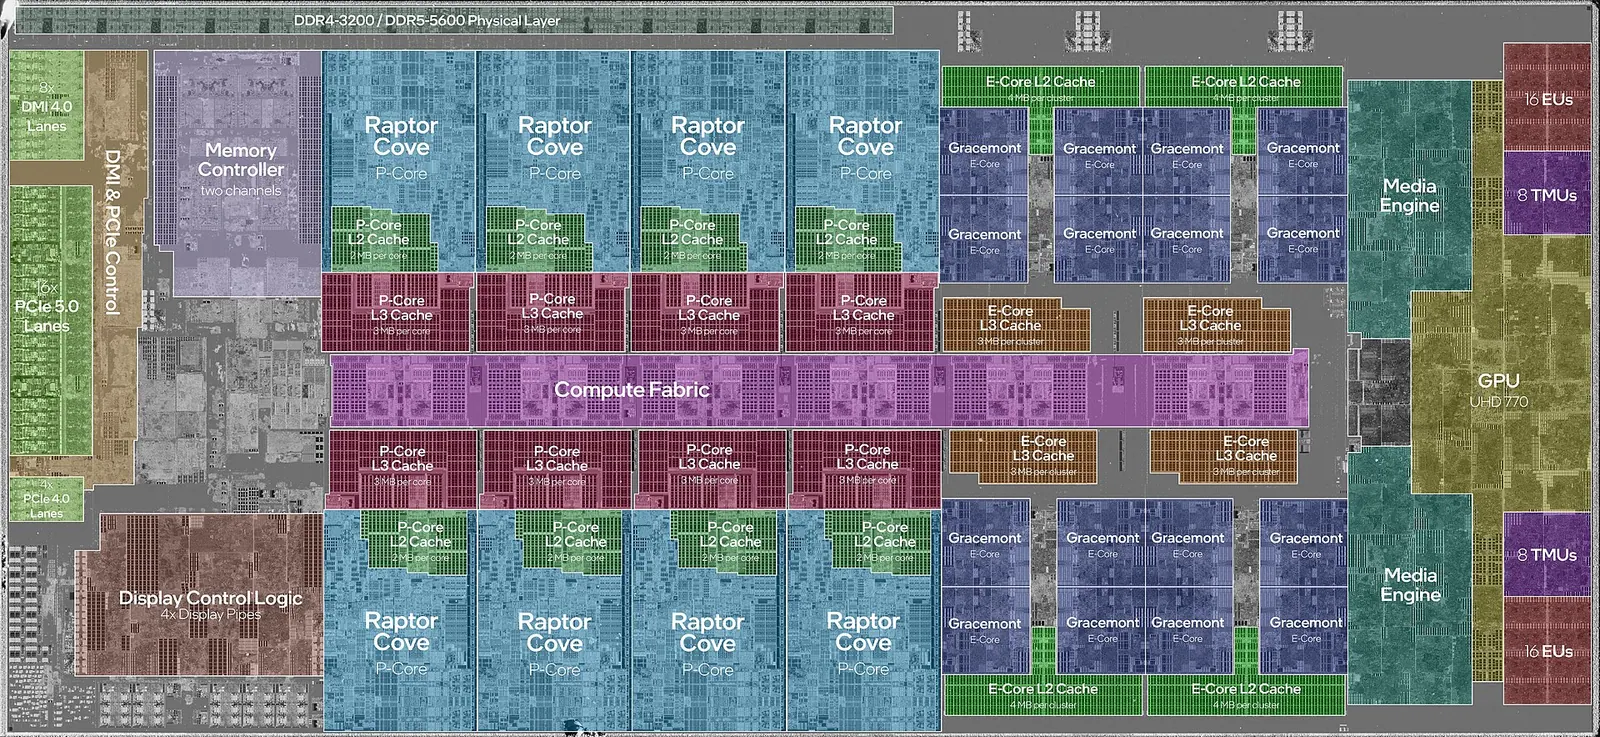
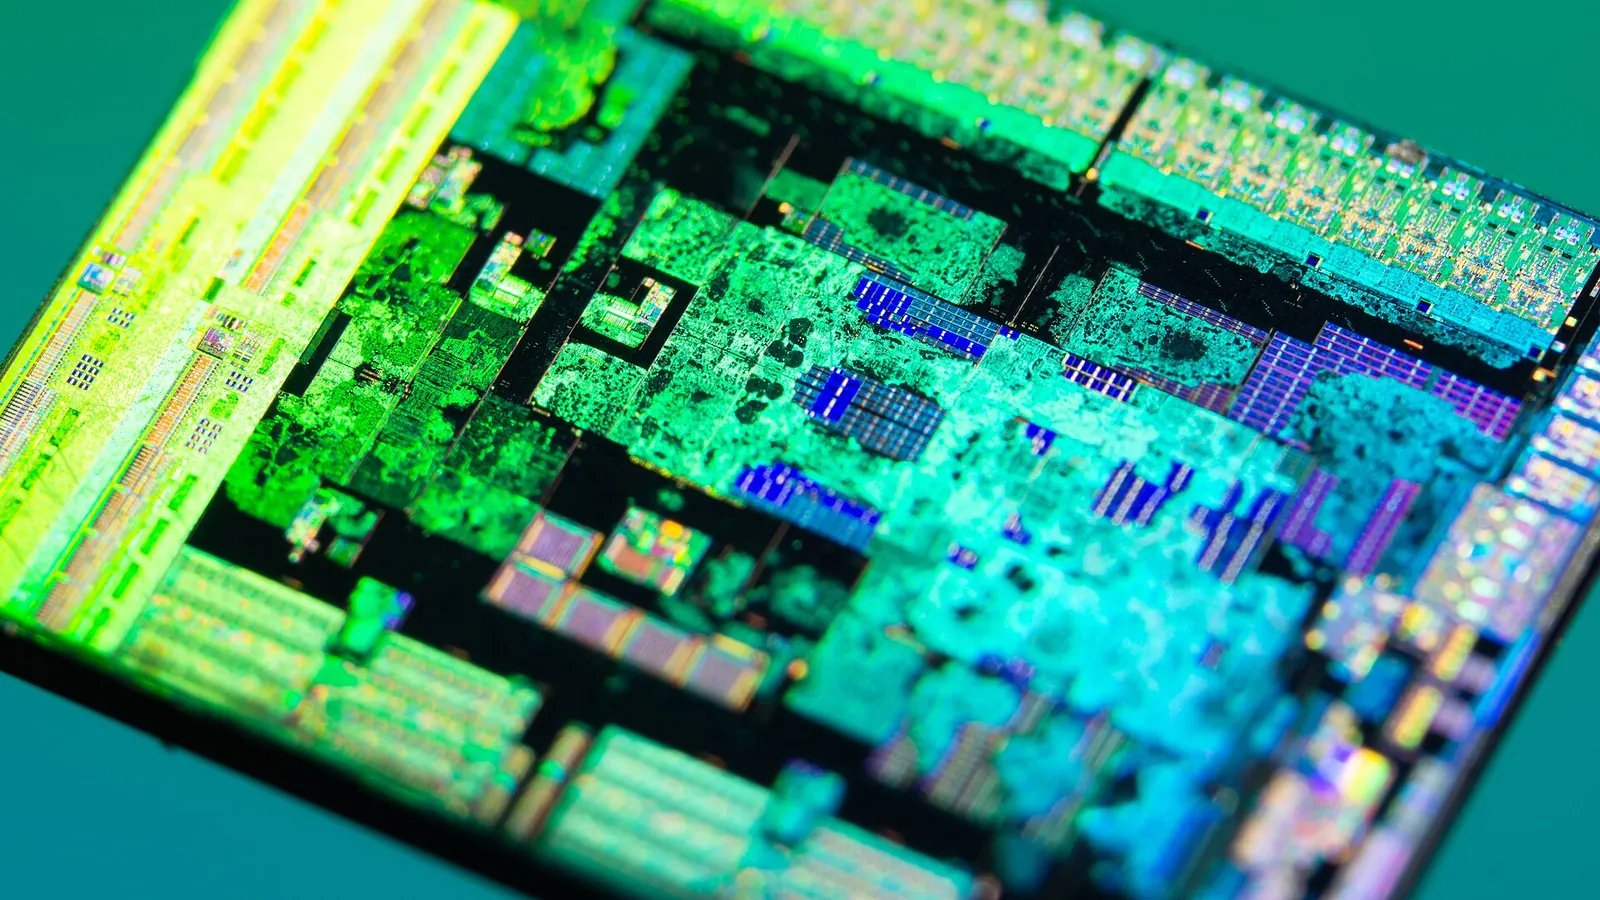
Nhìn ảnh chụp die của một con chip Intel Raptor Lake ở trên: các khối L2 (xanh lá) nằm ngay cạnh từng lõi P-Core, L3 (đỏ sẫm) xếp thành dải dọc theo đường bus nội bộ. Bộ điều khiển bộ nhớ (Memory Controller) và lớp giao tiếp DDR nằm ở rìa chip. Mọi thứ đi ra RAM đều phải chui qua cánh cổng ấy.
Phóng to một nano giây thành một giây
Nano giây quá nhỏ để cảm nhận, nên hãy thử phóng đại: coi 1 ns là 1 giây.
- Đọc từ L1 giống như với tay lấy cây bút trên bàn: 1 giây.
- Đọc từ L2 giống như mở ngăn kéo: khoảng 4 giây.
- Đọc từ L3 giống như đứng dậy lấy tập tài liệu trên kệ trong phòng: khoảng 12 giây.
- Đọc từ RAM giống như đi bộ ra cửa hàng đầu ngõ rồi quay về: hơn 1 phút.
Và nếu dữ liệu không có cả trong RAM mà phải đọc từ SSD NVMe (khoảng vài chục tới 100 micro giây), phép so sánh trở thành... đi một chuyến kéo dài cả ngày. Hiểu bức tranh này rồi thì sẽ thấy vì sao mọi tối ưu hiệu năng nghiêm túc đều xoay quanh một câu hỏi: dữ liệu có đang nằm sẵn trong cache không?
Lý do 1: RAM nằm xa và phải đi qua nhiều chặng
Cache được khắc ngay trên cùng miếng silicon với lõi xử lý. L1 nằm sát các khối tính toán, khoảng cách tính bằng micromet. RAM thì nằm trên thanh nhớ cắm ở khe DIMM trên bo mạch chủ, cách socket CPU cả chục centimet đường mạch đồng.
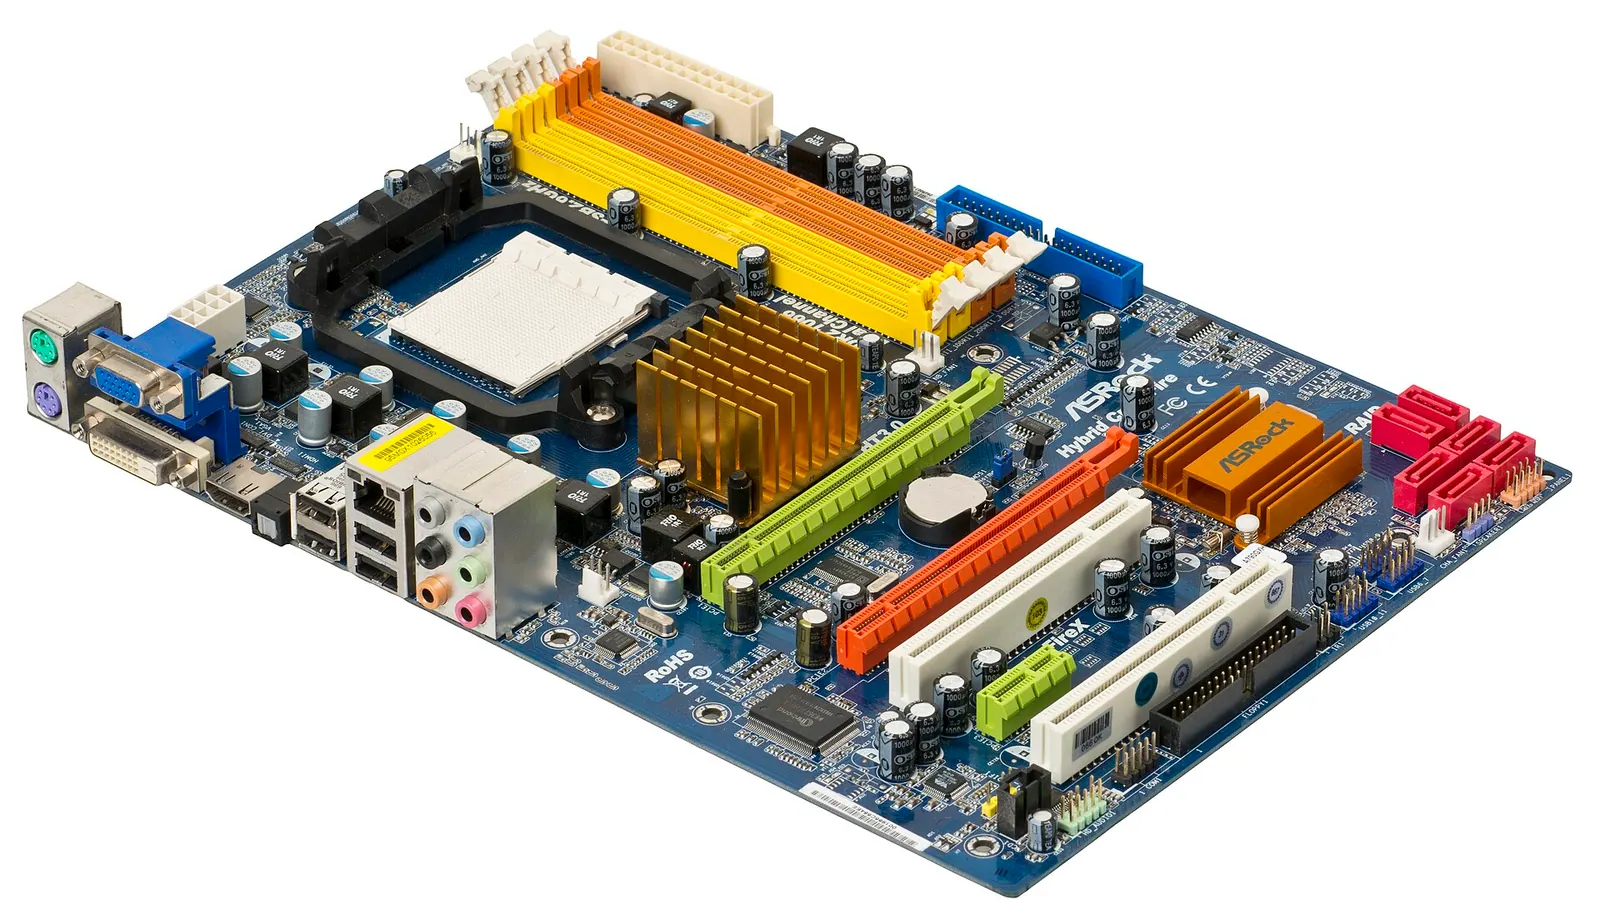
Tuy nhiên cần nói cho chính xác: riêng thời gian tín hiệu chạy trên 10 cm dây đồng chỉ chưa tới 1 ns. Khoảng cách vật lý không phải thủ phạm duy nhất. Cái tốn thời gian là cả chuỗi chặng mà một yêu cầu đọc phải đi qua:
- Lõi tra L1, trượt. Tra L2, trượt. Tra L3, trượt. Mỗi lần tra trượt đã tốn vài chục nhịp.
- Yêu cầu được chuyển qua mạng nội bộ của chip (ring bus, mesh hoặc Infinity Fabric) tới bộ điều khiển bộ nhớ.
- Bộ điều khiển xếp yêu cầu vào hàng đợi, sắp xếp lại với các yêu cầu khác để tận dụng hàng đang mở.
- Lệnh được gửi qua chân cắm, đi trên bus tới chip DRAM, đồng bộ theo xung nhịp của bus nhớ (chậm hơn nhiều so với xung lõi).
- Chip DRAM thực hiện các bước mở hàng, đọc cột (phần này chiếm 25–45 ns, xem mục dưới).
- Dữ liệu chạy ngược lại cả con đường trên, được nạp vào L3, L2, L1 rồi mới tới lõi.
Mỗi chặng thêm vài nano giây, cộng dồn lại thành 70–100 ns. Ở cache thì gần như không có chặng nào cả: dữ liệu nằm ngay đó.
Dòng chip X3D của AMD xếp thêm một tầng SRAM chồng lên die để L3 phình lên tới 96 MB. Mục đích chính là giảm số lần phải đi ra RAM. Với game, vốn truy cập dữ liệu khá lộn xộn, chỉ riêng việc tăng cache đã cho tăng khung hình rõ rệt mà không cần tăng xung.
Lý do 2: SRAM và DRAM cấu tạo khác hẳn nhau
Đây là lý do cốt lõi. Cache và RAM đều là "bộ nhớ", nhưng làm bằng hai công nghệ hoàn toàn khác nhau.
SRAM: sáu bóng bán dẫn khoá chặt vào nhau
Mỗi bit trong cache được lưu bằng một tế bào SRAM 6T, gồm sáu bóng bán dẫn. Bốn bóng (M1–M4) tạo thành hai cổng đảo nối vòng, cổng này giữ cổng kia ở trạng thái 0 hoặc 1. Hai bóng còn lại (M5, M6) là cửa nối ra hai đường dữ liệu BL và BL đảo.
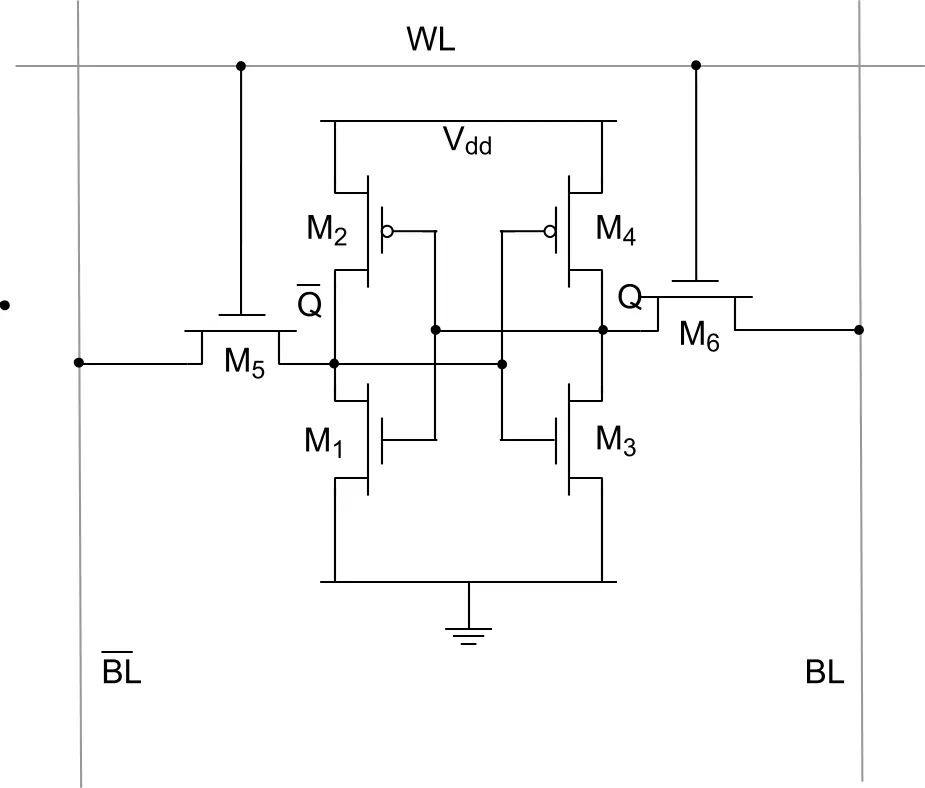
Vì mạch tự giữ trạng thái bằng nguồn điện liên tục, chỉ cần bật dây chọn (WL) là tế bào lập tức kéo hai đường dữ liệu lệch về hai phía. Không cần chờ, không cần nạp lại, đọc bao nhiêu lần cũng không mất dữ liệu. Đó là lý do SRAM đọc được trong vài nhịp.
DRAM: một tụ điện tí hon và một bóng bán dẫn
RAM chính dùng DRAM, mỗi bit chỉ gồm một tụ điện và một bóng bán dẫn (gọi là 1T1C). Tụ có điện tích nghĩa là 1, không có nghĩa là 0. Bóng bán dẫn đóng vai trò cái van nối tụ với đường bit (bit line).
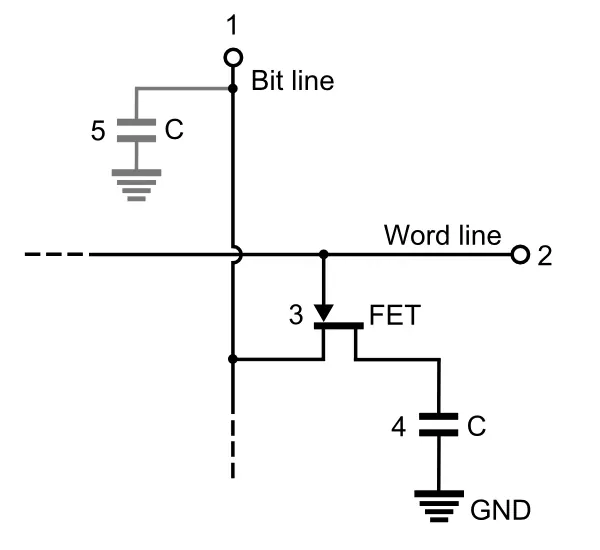
Vấn đề là tụ điện này cực kỳ nhỏ, chỉ chứa vài femtofarad. Khi mở van, lượng điện tích ấy chia sẻ với cả đường bit dài có điện dung lớn hơn nhiều lần, nên điện áp trên đường bit chỉ nhích lên hoặc tụt xuống một chút. Phải có bộ khuếch đại cảm biến (sense amplifier) so sánh chênh lệch rất nhỏ đó với mức tham chiếu rồi mới kết luận được là 0 hay 1. Quá trình chờ điện tích chia sẻ và khuếch đại chính là phần chậm.
Bàn cờ hàng và cột: vì sao đọc DRAM phải qua nhiều bước
Các tế bào DRAM được xếp thành ma trận hàng và cột. Mỗi hàng nối chung một word line, mỗi cột nối chung một bit line, và cuối mỗi cột là một bộ khuếch đại.
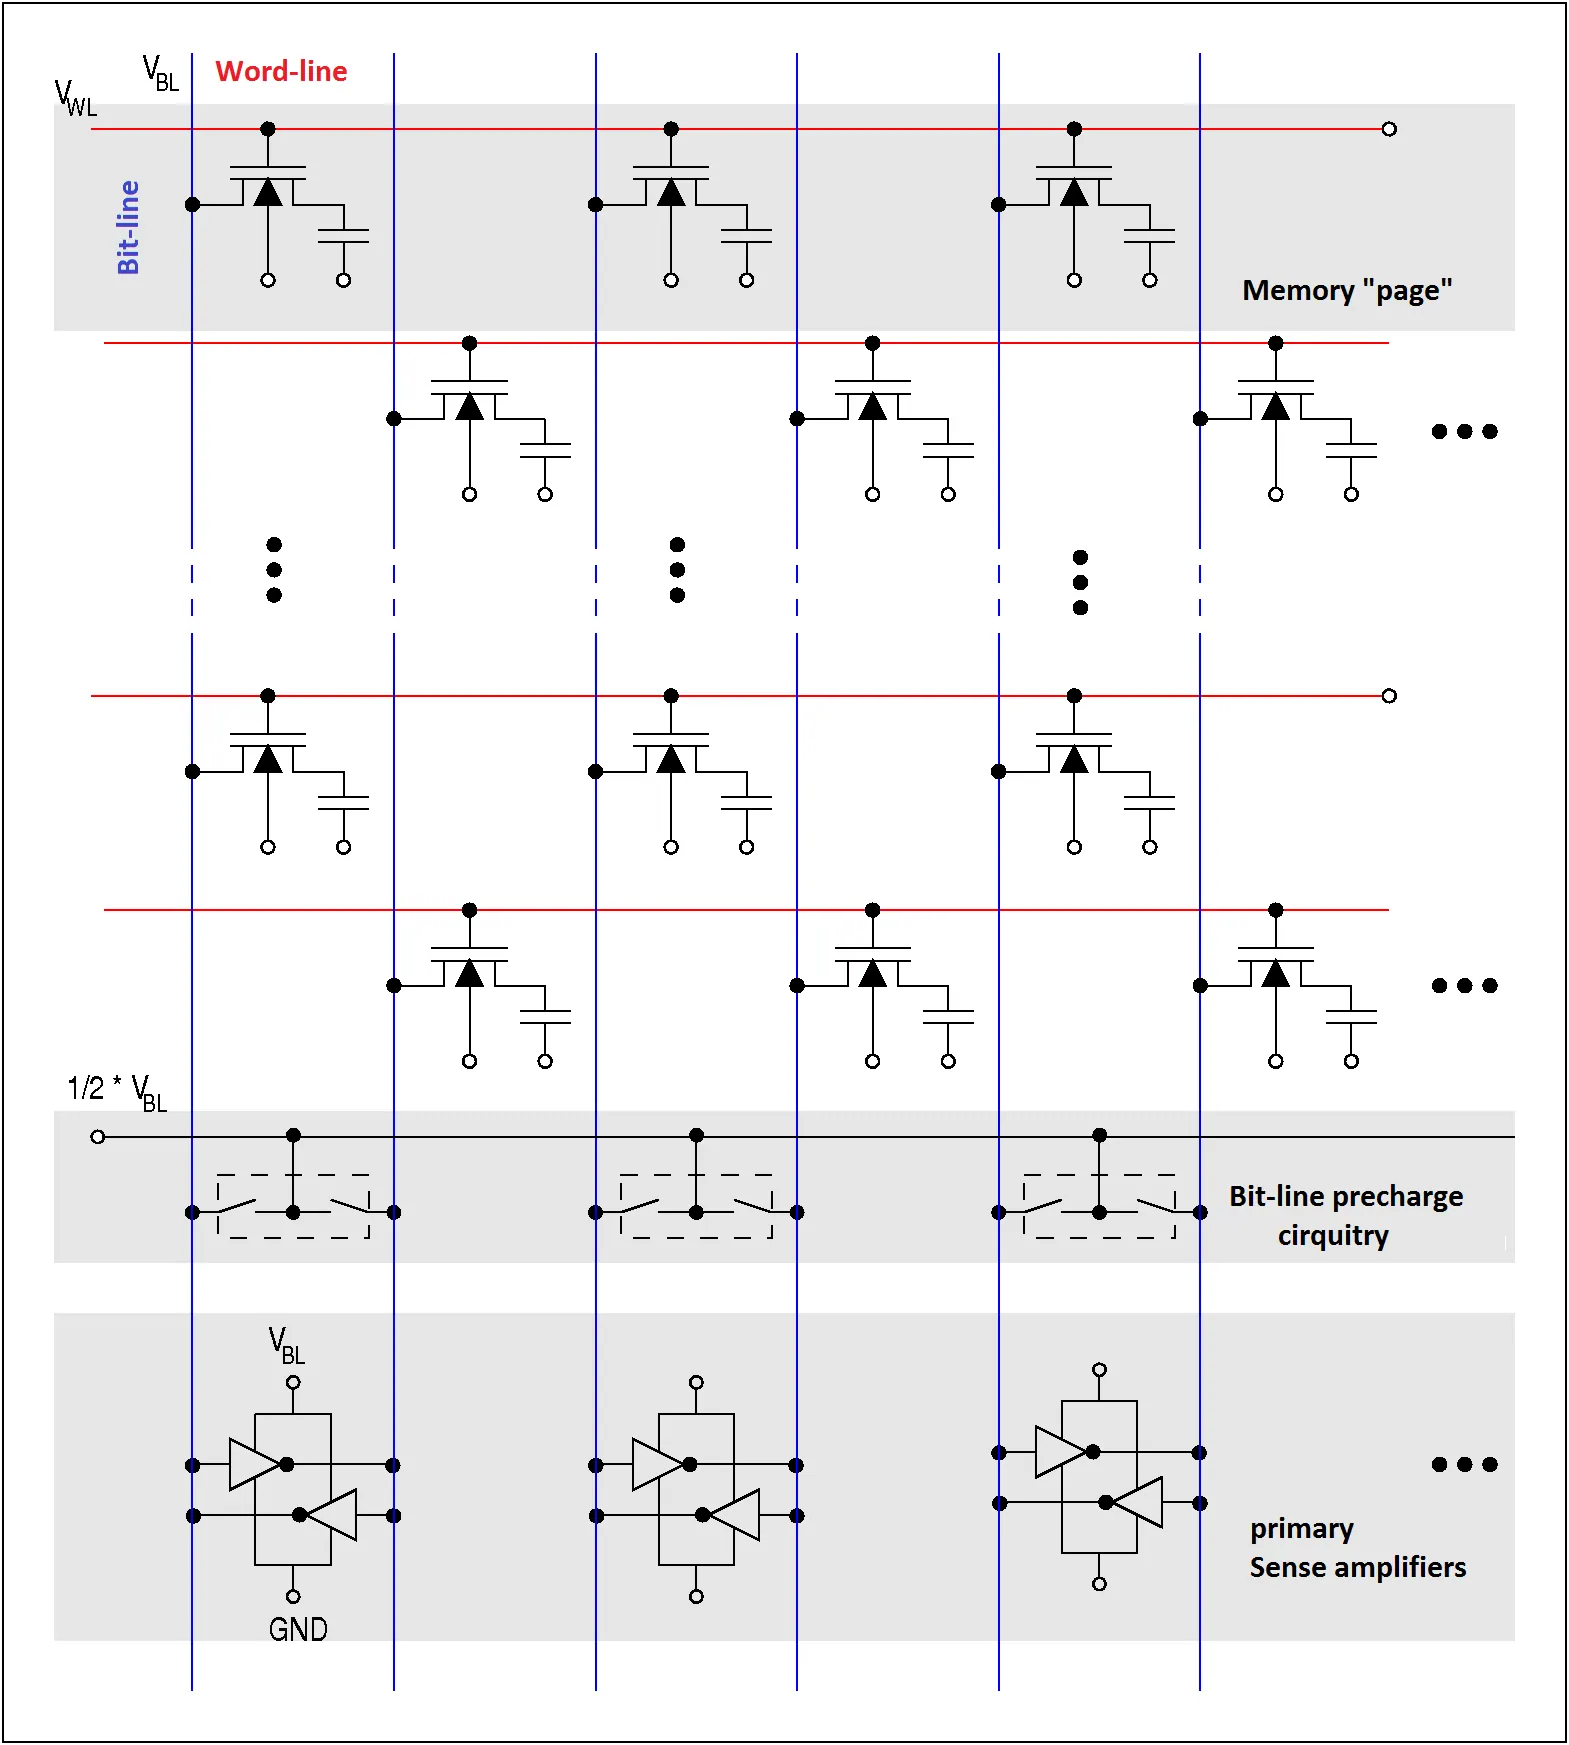
Để đọc một ô bất kỳ, chip DRAM phải đi qua ba bước, mỗi bước có thông số thời gian riêng bạn thường thấy in trên vỏ hộp RAM:
| Bước | Lệnh | Thông số | Việc diễn ra |
|---|---|---|---|
| 1. Mở hàng | ACTIVATE | tRCD | Bật cả một hàng, toàn bộ hàng được khuếch đại và chép vào bộ đệm hàng |
| 2. Đọc cột | READ | CL (CAS latency) | Chọn đúng cột cần lấy trong bộ đệm hàng và đẩy ra bus |
| 3. Đóng hàng | PRECHARGE | tRP | Ghi hàng trở lại, đưa đường bit về mức trung gian để chuẩn bị mở hàng khác |
Ví dụ một thanh DDR5-6000 CL30: CL30 nghĩa là 30 nhịp bus, quy ra 10 ns. Cộng thêm tRCD và tRP cùng cỡ đó, một lần đọc "xui" (phải đóng hàng cũ, mở hàng mới) đã tốn 30 ns chỉ riêng bên trong chip nhớ, chưa tính đường đi.
Ngược lại, nếu dữ liệu cần đọc nằm đúng ở hàng đang mở (gọi là row hit), bỏ được bước 1 và 3, chỉ còn trả giá CL. Bộ điều khiển bộ nhớ vì thế luôn cố gom các yêu cầu cùng hàng lại xử lý một lượt.
Đừng chỉ nhìn tốc độ MT/s. Độ trễ thật xấp xỉ bằng CL × 2000 / MT/s (tính ra ns). DDR4-3200 CL16 cho 10 ns, DDR5-6000 CL30 cũng cho 10 ns. Tức là DDR5 mạnh hơn chủ yếu ở băng thông, còn độ trễ tuyệt đối gần như giữ nguyên.
Đọc là xoá, và phải làm tươi liên tục
DRAM còn hai "món nợ" mà SRAM không có:
- Đọc là phá huỷ: khi tụ chia điện tích ra đường bit, nó mất luôn giá trị ban đầu. Bộ khuếch đại phải ghi ngược lại vào hàng trước khi hàng được đóng. Đó là một phần lý do tRP tồn tại.
- Tụ tự rò điện: dù không ai đọc, điện tích vẫn rò dần. Chuẩn JEDEC quy định mỗi hàng phải được làm tươi (refresh) ít nhất một lần trong 64 ms ở nhiệt độ bình thường, và nhanh gấp đôi khi chip nóng trên 85 độ C. Trong lúc một bank đang làm tươi, yêu cầu đọc vào bank đó phải chờ.
"RAM chậm vì xung thấp hơn CPU" chỉ đúng một phần. Cho dù bus nhớ chạy nhanh hơn nữa, các bước nạp điện, khuếch đại, ghi lại và làm tươi là giới hạn vật lý của tụ điện. Đó là lý do độ trễ DRAM tính bằng nano giây gần như đứng yên suốt hai mươi năm.
Vậy sao không làm cả RAM bằng SRAM?
Câu trả lời ngắn: diện tích và giá thành.
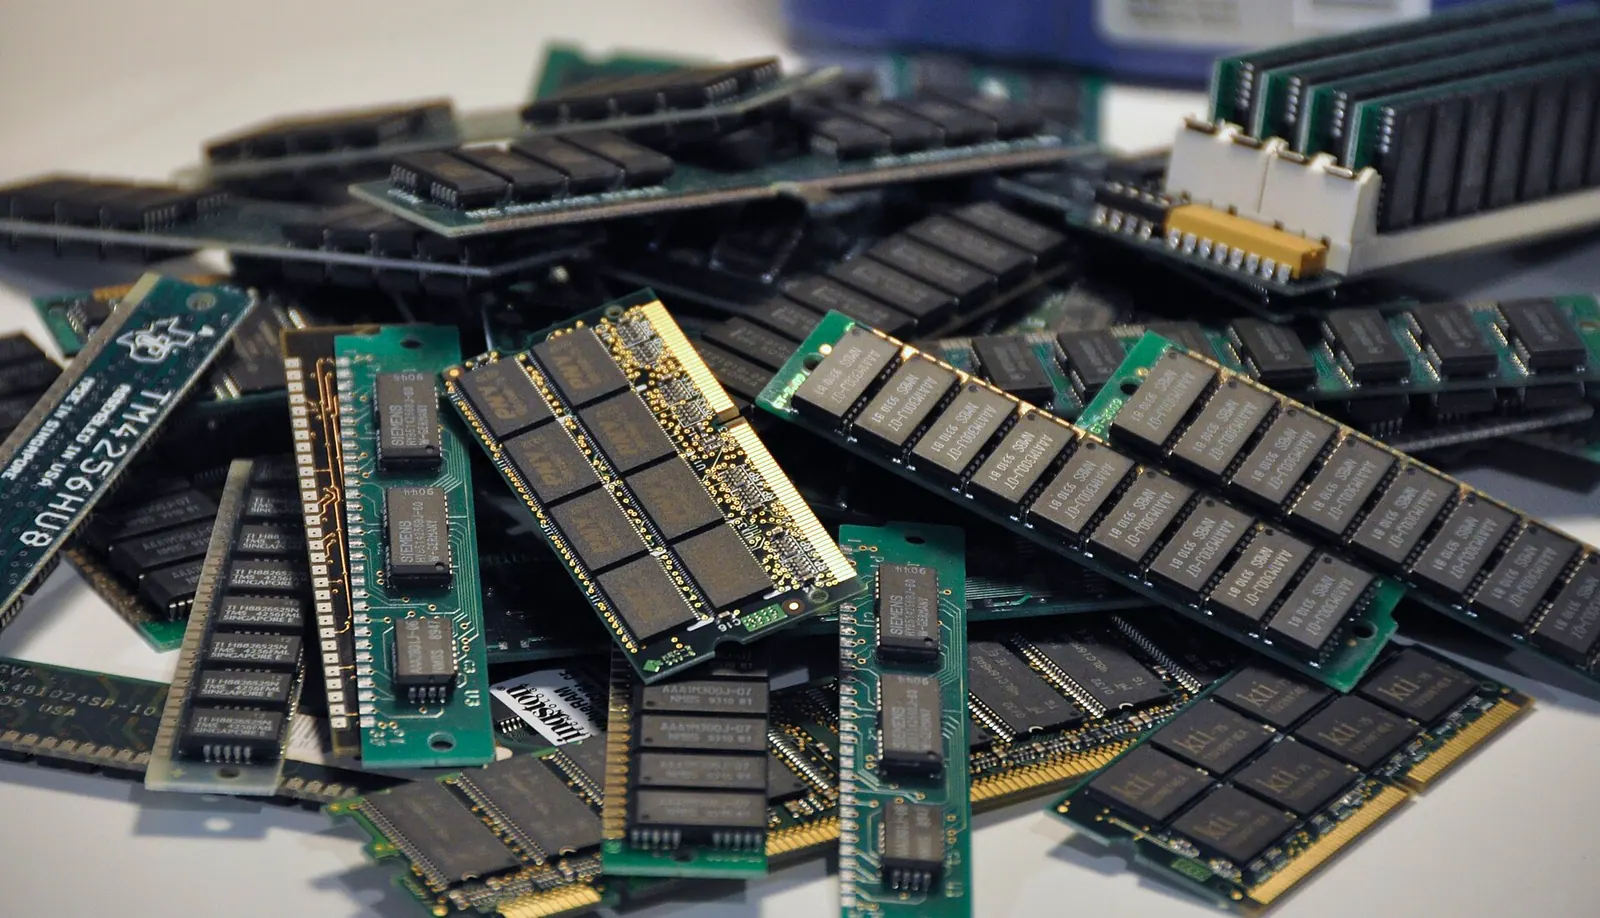
Một bit SRAM cần sáu bóng bán dẫn, một bit DRAM chỉ cần một bóng và một tụ điện xếp dọc sâu xuống silicon. Trên cùng một diện tích, DRAM nhét được nhiều bit hơn gấp nhiều lần. Thêm nữa, SRAM luôn hút điện để giữ trạng thái và tạo nhiệt đáng kể khi dung lượng lớn.
Hãy nhìn lại ảnh die ở đầu bài: chỉ 36 MB L3 cộng các khối L2 đã chiếm một phần lớn diện tích của một con chip cao cấp. Nếu muốn 32 GB bằng SRAM, bạn cần diện tích silicon gấp hàng trăm con CPU, giá thành và nhiệt lượng không thể chấp nhận. Trong khi một thanh RAM 32 GB chỉ cần vài chục chip DRAM nhỏ và có giá dễ chịu.
Một xu hướng đáng chú ý: ở các tiến trình mới (3 nm, 2 nm), tế bào SRAM gần như không thu nhỏ được thêm trong khi mạch logic vẫn thu nhỏ. Cache vì thế ngày càng "đắt" về diện tích, và các hãng chuyển sang xếp chồng cache lên die như AMD 3D V-Cache.
Hệ thống bộ nhớ nhiều tầng và nguyên lý cục bộ
Vì không có loại bộ nhớ nào vừa nhanh, vừa to, vừa rẻ, máy tính chia bộ nhớ thành nhiều tầng: nhỏ và nhanh ở gần lõi, to và chậm ở xa. Hệ thống này chạy hiệu quả nhờ hai thói quen của hầu hết chương trình:
- Cục bộ thời gian (temporal locality): dữ liệu vừa dùng thường sẽ được dùng lại ngay sau đó, như biến đếm vòng lặp hay hàm gọi nhiều lần.
- Cục bộ không gian (spatial locality): dữ liệu nằm cạnh nhau thường được dùng cùng nhau, như các phần tử liên tiếp của một mảng.
Để tận dụng cục bộ không gian, mỗi lần ra RAM CPU không lấy đúng 4 hay 8 byte mà chở về cả một dòng cache 64 byte. Thêm vào đó, bộ prefetcher trong CPU liên tục đoán trước: thấy bạn đọc các địa chỉ tăng đều, nó tự kéo các dòng kế tiếp về trước khi bạn kịp hỏi. Kết quả là với chương trình thông thường, tỉ lệ trúng cache thường trên 90%.
Có một công thức đơn giản cho thấy tỉ lệ trúng quan trọng thế nào. Thời gian truy cập trung bình bằng thời gian trúng cache cộng tỉ lệ trượt nhân với cái giá khi trượt:
| Tỉ lệ trượt ra RAM | Thời gian trung bình (L1 1 ns, RAM 80 ns) |
|---|---|
| 1% | 1 + 0,01 × 80 = 1,8 ns |
| 5% | 1 + 0,05 × 80 = 5 ns |
| 20% | 1 + 0,20 × 80 = 17 ns |
Chỉ từ 1% lên 20% trượt cache, tốc độ truy cập trung bình chậm đi gần 10 lần dù phần cứng không đổi.
Tác động thực tế: viết code thân thiện với cache
Đây là phần lập trình viên hưởng lợi trực tiếp. Khi trượt cache, lõi có thể đứng chờ hàng trăm nhịp. CPU hiện đại có thực thi không theo thứ tự để làm việc khác trong lúc chờ, nhưng chỉ che được một phần.
Ví dụ kinh điển: duyệt một mảng liên tục và duyệt một danh sách liên kết có cùng số phần tử, cùng số phép cộng.
- Mảng: các phần tử nằm sát nhau, một dòng 64 byte chứa 16 số nguyên 4 byte. Prefetcher đoán được hướng đi và kéo dữ liệu về trước.
- Danh sách liên kết: mỗi nút nằm rải rác trong bộ nhớ, phải đọc xong nút này mới biết địa chỉ nút sau. Prefetcher bó tay, mỗi bước có thể là một lần trượt ra RAM.
Với dữ liệu lớn hơn cache, chênh lệch có thể tới gấp 10 lần hoặc hơn, dù độ phức tạp thuật toán trên giấy là như nhau.
Bạn có thể tự kiểm tra cấu hình cache của máy mình trên Linux:
lscpu | grep -i cache
getconf -a | grep -i CACHE_LINESIZE
Một số nguyên tắc hay dùng:
- [ ]Ưu tiên mảng và vector liền mạch thay cho danh sách liên kết hoặc cây con trỏ khi dữ liệu lớn.
- [ ]Duyệt mảng hai chiều theo đúng thứ tự lưu trong bộ nhớ (theo hàng với C/C++, theo cột với Fortran).
- [ ]Tách các trường hay dùng ra khỏi trường ít dùng để mỗi dòng cache chứa nhiều dữ liệu có ích hơn.
- [ ]Tránh để hai luồng ghi vào hai biến nằm chung một dòng 64 byte (false sharing).
RAM không chậm vì làm ẩu. Nó chậm vì được thiết kế để to và rẻ. Cache tồn tại để che giấu sự chậm ấy, và code tốt là code giúp cache làm việc dễ hơn.
Tóm tắt nhanh
- Đọc L1 mất khoảng 1 ns, L3 khoảng 10–12 ns, còn RAM khoảng 70–100 ns, tức hơn 300 nhịp ở 4 GHz.
- RAM chậm vì yêu cầu phải đi qua nhiều chặng: tra trượt các tầng cache, mạng nội bộ chip, bộ điều khiển bộ nhớ, bus, rồi mới tới chip nhớ.
- DRAM dùng tụ điện tí hon nên phải khuếch đại, mở hàng, đọc cột, ghi lại và làm tươi mỗi 64 ms; SRAM dùng 6 bóng bán dẫn tự giữ trạng thái nên đọc gần như tức thì.
- Không làm cả RAM bằng SRAM vì quá tốn diện tích, điện và tiền.
- Cache hiệu quả nhờ nguyên lý cục bộ và dòng cache 64 byte; code duyệt dữ liệu liền mạch có thể nhanh hơn gấp nhiều lần.
Câu hỏi thường gặp
Nâng RAM bus cao hơn có giảm độ trễ không?
Có, nhưng ít hơn bạn nghĩ. Độ trễ thật phụ thuộc cả tốc độ lẫn thông số CL. DDR5 tốc độ cao nhưng CL cũng cao, nên độ trễ tính bằng nano giây xấp xỉ DDR4 tốt. Lợi ích chính của RAM nhanh là băng thông, quan trọng với GPU tích hợp và tác vụ xử lý dữ liệu lớn.
Thêm RAM có làm máy nhanh hơn không?
Chỉ khi máy đang thiếu RAM và phải dùng ổ đĩa làm bộ nhớ ảo. Thêm RAM không làm từng lần đọc nhanh hơn, nó chỉ giúp tránh trường hợp tệ hơn nhiều là đọc từ SSD.
Cache L3 to hơn có luôn tốt hơn?
Không luôn luôn. Cache to hơn thường có độ trễ cao hơn một chút. Nó có lợi rõ với game, cơ sở dữ liệu, mô phỏng, nơi tập dữ liệu làm việc lớn và truy cập lộn xộn. Với tác vụ đã nằm gọn trong cache hiện có, lợi ích không đáng kể.
Lập trình viên web có cần quan tâm chuyện này không?
Ít khi cần tối ưu tới mức dòng cache, nhưng hiểu nó giúp bạn chọn cấu trúc dữ liệu đúng, hiểu vì sao Redis hay các engine cơ sở dữ liệu nhấn mạnh việc giữ dữ liệu trong bộ nhớ, và vì sao một vòng lặp đơn giản đôi khi chậm bất thường khi dữ liệu lớn dần.