Bạn gõ int tuoi = 25;, bấm chạy, và chương trình in ra đúng số 25. Đơn giản như đổ nước vào cốc. Nhưng nếu ai đó hỏi "cái cốc ấy nằm ở đâu trong thanh RAM đang cắm trên bo mạch?", phần lớn chúng ta sẽ ngập ngừng.
Câu trả lời đi qua khá nhiều tầng: trình biên dịch, hệ điều hành, một mạch phần cứng tên MMU, rồi tới cache và thanh ghi trong CPU. Bài này đi lần lượt từng tầng, để lần sau nhìn một dòng khai báo biến, bạn thấy được cả hành trình phía sau nó.
RAM thật ra trông như thế nào từ bên trong?
Nhìn từ ngoài, thanh RAM là một tấm mạch có vài con chip đen. Nhìn bằng con mắt của CPU, nó đơn giản đến bất ngờ: một dãy ô nhớ khổng lồ xếp thẳng hàng. Không có thư mục, không có tên biến, không có kiểu dữ liệu. Mỗi ô chứa đúng một byte, tức 8 bit, đủ để ghi một số từ 0 đến 255.
Mỗi ô có một số thứ tự gọi là địa chỉ (address). Hãy hình dung một con phố rất dài, nhà nào cũng có số: nhà số 0, nhà số 1, nhà số 2... Muốn gửi đồ hay lấy đồ, bạn chỉ cần biết số nhà. CPU cũng vậy: nó không hỏi "biến tuổi đâu?", nó hỏi "cho tôi byte ở địa chỉ 140.732...."
Con phố này dài cỡ nào? Một máy có 16 GB RAM chứa 16 × 1.073.741.824 = 17.179.869.184 byte, tức khoảng 17 tỷ "căn nhà". Địa chỉ thường được viết ở hệ thập lục phân (hex) cho gọn, nên bạn hay thấy những thứ như 0x7ffd5e8c3a4c khi in địa chỉ ra màn hình.
RAM không cho bạn đánh địa chỉ từng bit. Muốn đổi một bit, CPU phải đọc cả byte (thực tế là cả một khối lớn hơn), sửa bit đó rồi ghi lại. Vì vậy kiểu bool trong C++ vẫn chiếm trọn 1 byte dù chỉ cần 1 bit.
Tên biến "tuổi" đi đâu sau khi biên dịch?
Đây là chỗ nhiều người bất ngờ nhất: CPU không bao giờ biết chữ "tuổi" tồn tại. Tên biến chỉ là cái nhãn dành cho con người. Khi biên dịch, compiler (trình biên dịch) đọc code của bạn, quyết định biến này cần bao nhiêu byte, đặt nó ở đâu, rồi thay mọi chỗ nhắc tới tuoi bằng một địa chỉ, thường ở dạng "cách đỉnh vùng nhớ hiện tại bao nhiêu byte".
Dòng int tuoi = 25; sau khi biên dịch cho x86-64 có thể chỉ còn một lệnh máy kiểu:
mov DWORD PTR [rbp-4], 25
Dịch ra lời thường: "ghi số 25, dài 4 byte, vào địa chỉ nằm dưới thanh ghi rbp 4 byte". Chữ "tuoi" đã biến mất. Nó chỉ còn sống trong file thông tin gỡ lỗi (debug symbols) để công cụ như gdb hiển thị lại cho bạn đọc.
Số 25 được xếp vào bốn ô như thế nào?
Kiểu int trên hầu hết máy hiện nay chiếm 4 byte, nên số 25 được trải trên 4 ô liền nhau. Viết ở hex, 25 là 0x00000019. Câu hỏi là byte nào đặt trước?
Trên chip Intel, AMD và ARM (ở chế độ mặc định), byte nhỏ nhất được đặt ở địa chỉ thấp nhất. Cách xếp này gọi là little endian (đầu nhỏ trước):
| Địa chỉ | A | A+1 | A+2 | A+3 |
|---|---|---|---|---|
| Little endian (x86, ARM) | 19 | 00 | 00 | 00 |
| Big endian (giao thức mạng) | 00 | 00 | 00 | 19 |
Ngày thường bạn không cần quan tâm. Nhưng khi đọc file nhị phân, gửi dữ liệu qua mạng (vốn quy ước big endian) hay ép kiểu con trỏ, nhầm thứ tự byte là cách nhanh nhất để số 25 biến thành 419.430.400.
Stack: chồng đĩa của các hàm
Biết biến chiếm 4 ô rồi, vậy 4 ô đó nằm ở khu nào của con phố? Câu trả lời phụ thuộc vào loại biến. Một chương trình đang chạy chia vùng nhớ của nó thành vài khu, mỗi khu có luật riêng.
Biến cục bộ khai báo trong hàm nằm trên stack (ngăn xếp). Cứ nghĩ tới chồng đĩa trong bếp: đĩa đặt lên sau cùng thì được lấy ra đầu tiên. Luật này có tên LIFO (vào sau, ra trước).
Mỗi lần gọi hàm, CPU "đặt thêm một cái đĩa": một stack frame (khung ngăn xếp) chứa các biến cục bộ, tham số và địa chỉ để quay về chỗ gọi. Hàm chạy xong, khung đó bị gỡ đi ngay. Việc cấp và thu hồi chỉ là dịch con trỏ đỉnh stack lên xuống vài chục byte, nên cực kỳ nhanh.
Đó cũng là lý do một lỗi kinh điển xảy ra:
int* tao_so() {
    int x = 25;
    return &x;   // trả về địa chỉ của một biến sắp "bốc hơi"
}
Khi tao_so() kết thúc, khung của nó bị gỡ, x không còn thuộc về ai. Con trỏ trả về vẫn trỏ vào đúng chỗ cũ, nhưng chỗ đó sẽ bị lần gọi hàm tiếp theo ghi đè. Compiler hiện đại thường cảnh báo, nhưng không phải lúc nào cũng bắt được.
Trên Linux, stack của luồng chính mặc định thường là 8 MB (kiểm tra bằng ulimit -s, kết quả 8192 tức 8192 KB). Trên Windows, mặc định chỉ khoảng 1 MB. Gọi đệ quy quá sâu hoặc khai báo mảng cục bộ vài chục MB sẽ làm tràn stack, và chương trình sập với lỗi stack overflow.
ulimit -s
# 8192
Heap, con trỏ và vùng dữ liệu tĩnh
Vậy dữ liệu lớn, hoặc cần sống lâu hơn hàm tạo ra nó, thì để đâu? Đó là việc của heap (vùng nhớ động). Khi bạn gọi malloc trong C hay new trong C++, Java, C#, bộ cấp phát tìm một khoảng trống đủ lớn trong heap, đánh dấu là đã dùng, rồi trả về địa chỉ của khoảng đó.
Nếu stack là chồng đĩa gọn gàng, heap giống bãi gửi xe: ai tới thì tìm chỗ trống mà đỗ, ai về thì chỗ đó trống ra. Lâu dần bãi bị lỗ chỗ, gọi là phân mảnh (fragmentation). Tìm chỗ trống tốn công hơn hẳn việc dịch con trỏ stack, nên cấp phát heap chậm hơn.
Địa chỉ mà malloc trả về phải được cất vào đâu đó, và đó chính là con trỏ (pointer). Điều quan trọng cần hiểu: con trỏ cũng chỉ là một biến bình thường. Nó có địa chỉ riêng, thường nằm trên stack, và giá trị bên trong là một địa chỉ khác. Trên máy 64-bit, con trỏ dài 8 byte.
int* p = malloc(sizeof(int));  // p nằm trên stack, 8 byte
*p = 25;                       // số 25 nằm trên heap, 4 byte
free(p);                       // trả chỗ lại cho heap
Quên free thì vùng nhớ đó bị giữ mãi tới khi chương trình tắt, đó là memory leak (rò rỉ bộ nhớ). Các ngôn ngữ như Java, Python, JavaScript, Go có bộ thu gom rác (garbage collector) tự dọn những vùng không còn ai trỏ tới, đổi lại là thỉnh thoảng phải dừng một chút để dọn.
Vùng tĩnh: những cư dân sống lâu nhất
Biến toàn cục, biến static và hằng số thì không nằm ở stack hay heap. Chúng ở vùng dữ liệu tĩnh, được nạp sẵn từ file chạy khi chương trình khởi động và tồn tại tới lúc chương trình tắt. Trong file thực thi, vùng này chia nhỏ thành .data (biến có giá trị ban đầu), .bss (biến khởi tạo bằng 0) và .rodata (hằng số, chuỗi ký tự, chỉ đọc).
| Khu vực | Chứa gì | Sống bao lâu | Ai dọn |
|---|---|---|---|
| Stack | Biến cục bộ, tham số | Tới khi hàm kết thúc | Tự động |
| Heap | Dữ liệu new/malloc |
Tới khi free hoặc GC dọn |
Lập trình viên hoặc GC |
| Vùng tĩnh | Biến toàn cục, hằng số | Suốt chương trình | Hệ điều hành khi thoát |
| Vùng code | Lệnh máy của chương trình | Suốt chương trình | Hệ điều hành khi thoát |
Cú lừa lớn nhất: địa chỉ bạn in ra là địa chỉ ảo
Tới đây có vẻ như ta đã tìm ra căn nhà của biến tuoi. Thử printf("%p", &tuoi) và bạn sẽ thấy một con số như 0x7ffd5e8c3a4c. Nhưng con số này không phải vị trí thật trên thanh RAM. Đó là địa chỉ ảo (virtual address).
Hệ điều hành cho mỗi chương trình một không gian địa chỉ ảo riêng, như thể nó sở hữu toàn bộ bộ nhớ một mình. Trên x86-64 phổ biến hiện nay, địa chỉ ảo dùng 48 bit, tức không gian 256 TB, trong đó nửa dưới 128 TB dành cho chương trình người dùng. Rộng hơn rất nhiều lần so với RAM thật trong máy.
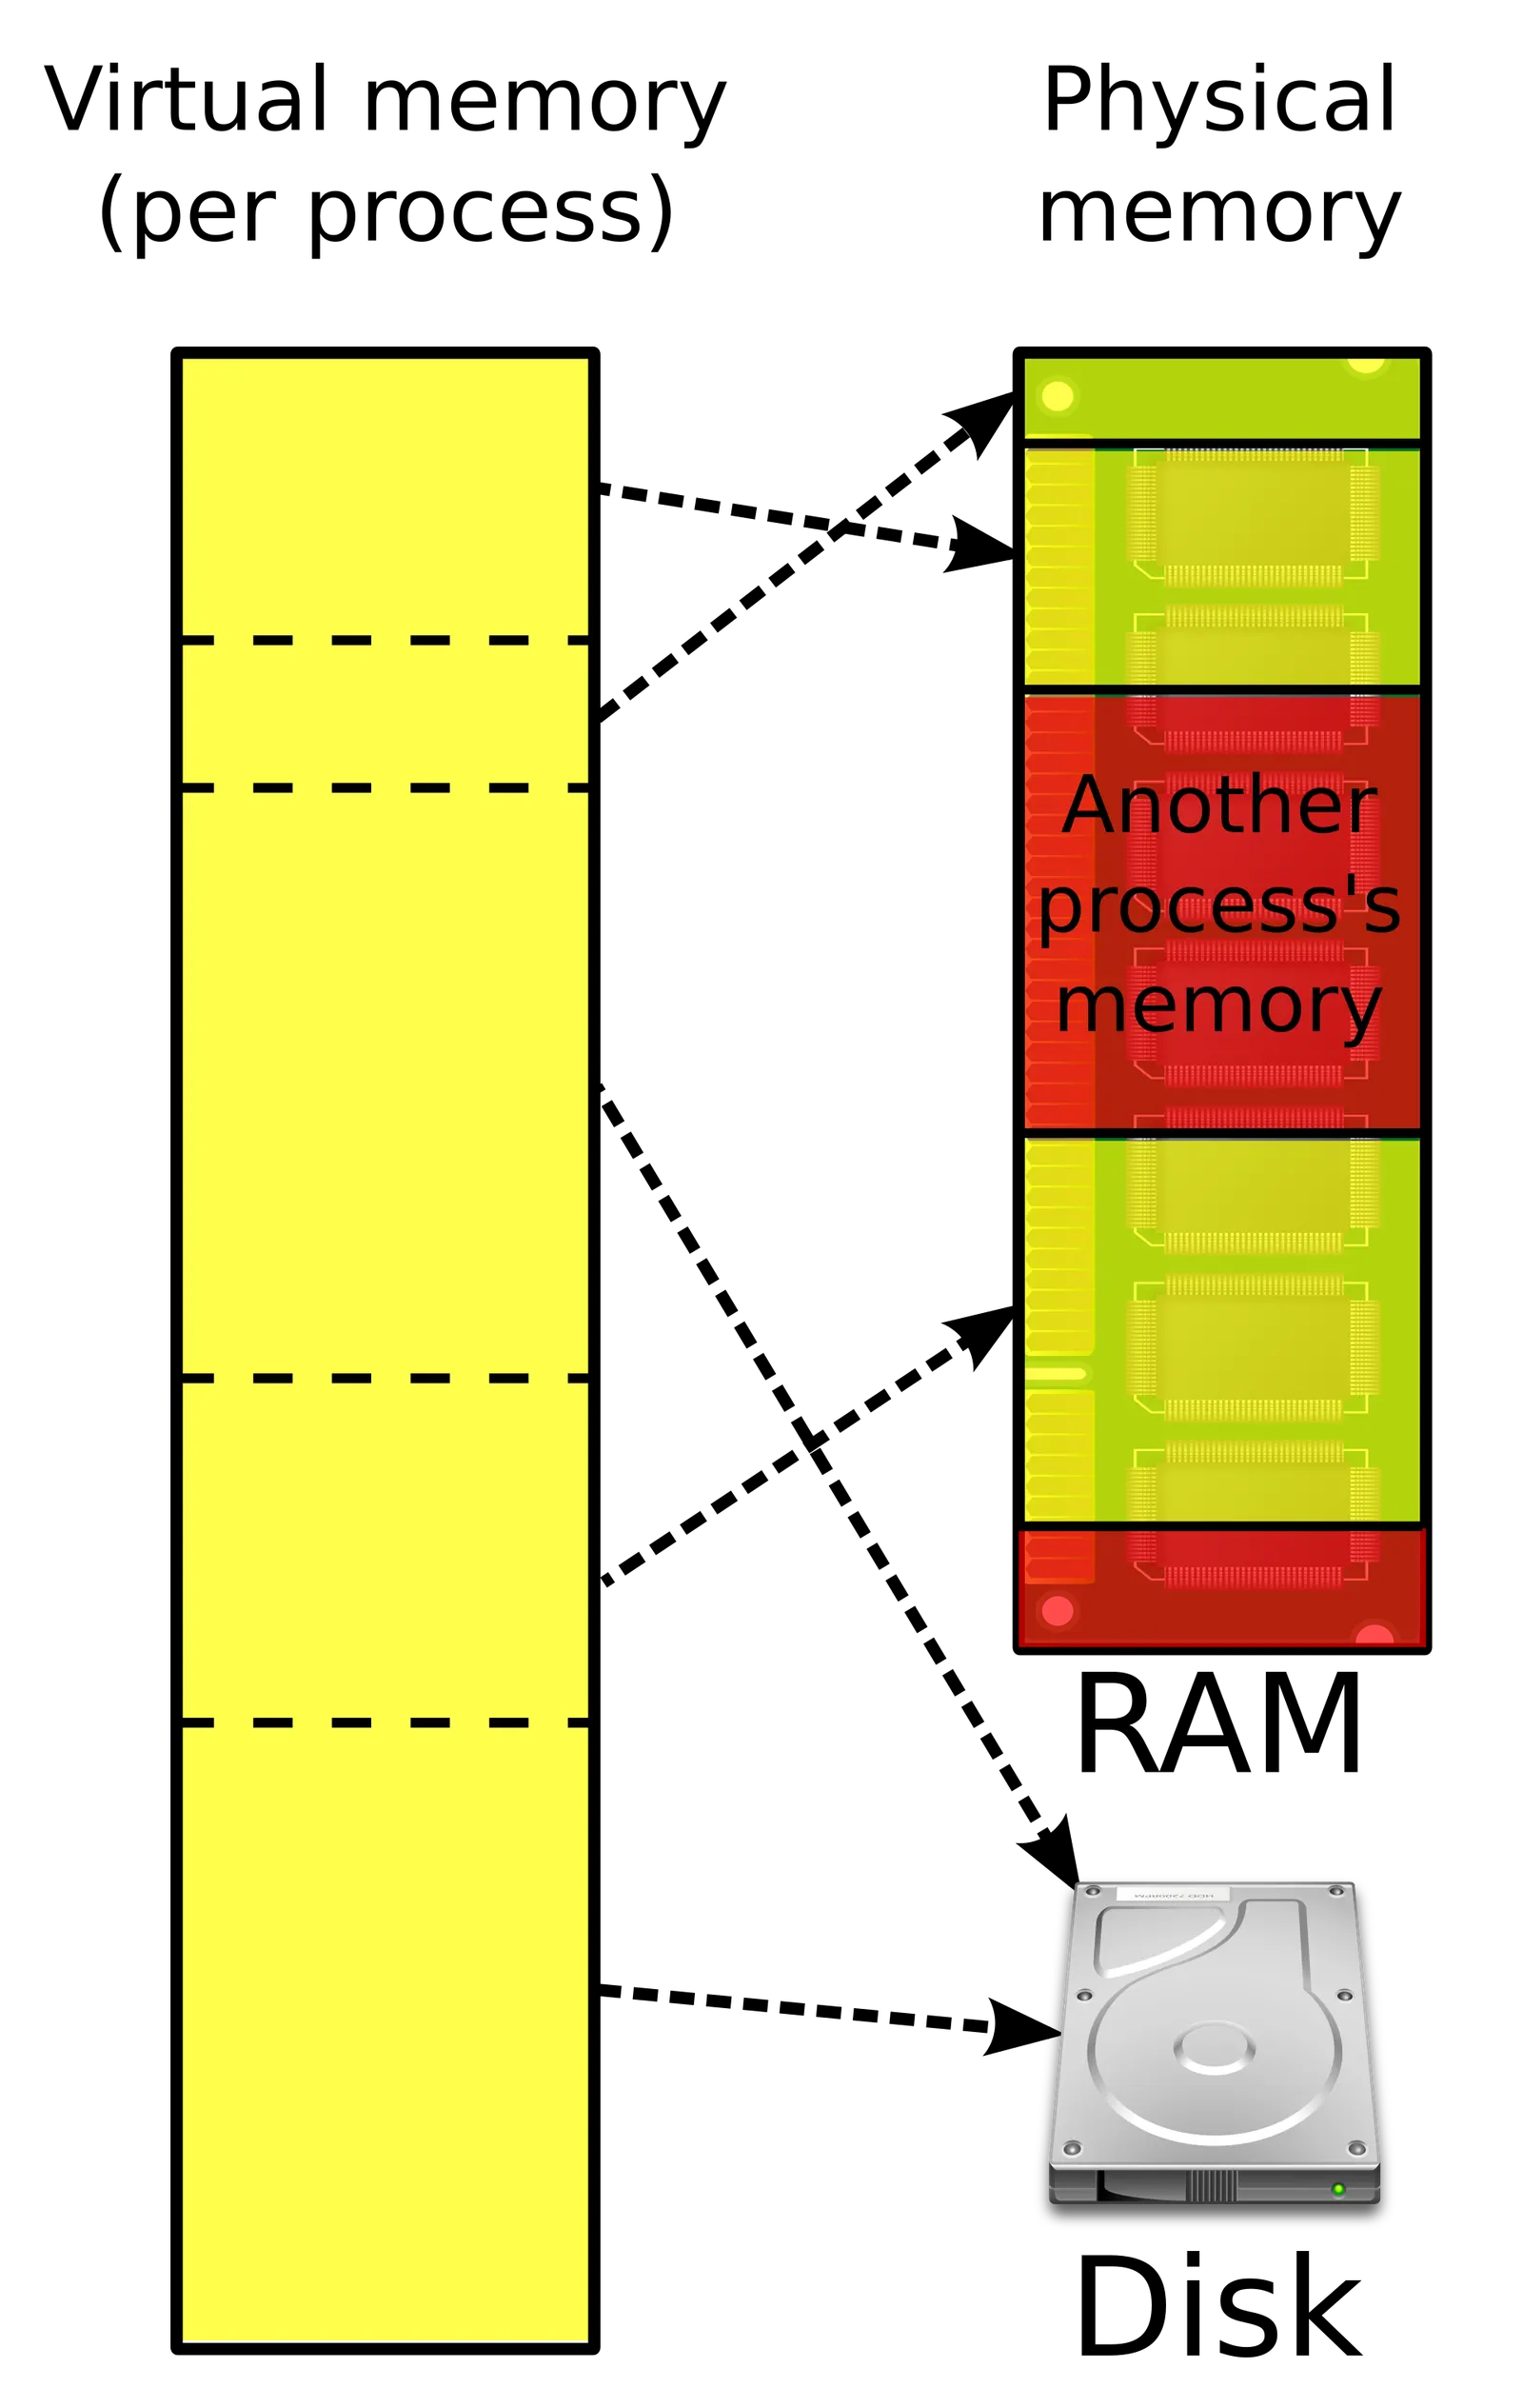
Người dịch địa chỉ ảo sang địa chỉ thật là MMU (Memory Management Unit, bộ quản lý bộ nhớ), một mạch phần cứng nằm trong CPU. Bộ nhớ được chia thành các trang (page), thường 4 KB. Hệ điều hành giữ cho mỗi chương trình một bảng trang (page table) ghi "trang ảo số này nằm ở khung vật lý số kia". Mỗi lần truy cập bộ nhớ, MMU tra bảng này. Để khỏi tra đi tra lại, nó nhớ các kết quả gần nhất trong một bộ đệm nhỏ tên TLB.
Hệ quả rất thú vị:
- Hai chương trình có thể dùng cùng một địa chỉ ảo mà dữ liệu nằm ở hai nơi khác hẳn nhau trong RAM. Chương trình A không thể đọc trộm biến của chương trình B.
- Trang chưa dùng thì chưa cần RAM thật. Chương trình xin 1 GB nhưng chỉ chạm vào 10 MB thì chỉ tốn khoảng 10 MB RAM.
- Trang ít dùng có thể bị đẩy ra ổ đĩa (swap hoặc pagefile). Khi cần lại, hệ điều hành nạp về, đó là lúc máy bỗng ì ạch khi mở quá nhiều tab.
- Truy cập vào trang không được phép thì MMU báo lỗi, và chương trình nhận thông báo quen thuộc segmentation fault.
Các hệ điều hành hiện đại bật ASLR (ngẫu nhiên hoá bố cục không gian địa chỉ): vị trí stack, heap và thư viện bị xáo ngẫu nhiên mỗi lần chạy. Mục đích là làm khó kẻ tấn công, vì họ không thể đoán trước biến hay hàm quan trọng nằm ở đâu.
Chặng cuối: cache và thanh ghi trong lõi CPU
Kể cả khi đã tìm ra ô RAM thật, câu chuyện vẫn chưa hết. RAM nhanh, nhưng so với CPU thì vẫn chậm: một lần đọc RAM tốn cỡ vài chục tới hơn trăm nano giây, trong khi lõi CPU chạy hàng tỷ chu kỳ mỗi giây. Đợi RAM cho từng phép cộng thì CPU sẽ ngồi chơi phần lớn thời gian.
Vì vậy giữa CPU và RAM có nhiều tầng cache (bộ nhớ đệm) L1, L2, L3 nằm ngay trên con chip. CPU không đọc lẻ từng byte mà kéo cả một cache line, thường 64 byte, về cache. Biến tuoi và những biến nằm sát nó được kéo về cùng lúc. Đây là lý do duyệt mảng theo thứ tự liền nhau nhanh hơn nhiều so với nhảy lung tung trong bộ nhớ.
Tầng trong cùng là thanh ghi (register): vài chục ô nhớ nằm ngay trong lõi, nơi các phép tính thực sự diễn ra. Và đây là kết cục bất ngờ: khi bật tối ưu (-O2), compiler thường giữ những biến nhỏ, dùng nhiều, như biến đếm vòng lặp, chỉ trong thanh ghi. Biến đó không bao giờ có địa chỉ, không bao giờ chạm tới RAM. Chỉ khi bạn lấy địa chỉ của nó bằng &, compiler mới buộc phải cấp cho nó một chỗ trong bộ nhớ.
| Tầng | Dung lượng điển hình | Tốc độ tương đối |
|---|---|---|
| Thanh ghi | Vài trăm byte | Nhanh nhất, gần như tức thì |
| Cache L1 | Vài chục KB mỗi lõi | Vài chu kỳ |
| Cache L2, L3 | Vài trăm KB tới vài chục MB | Chục tới vài chục chu kỳ |
| RAM | Vài GB tới vài trăm GB | Hàng trăm chu kỳ |
| SSD (swap) | Hàng trăm GB trở lên | Chậm hơn RAM hàng trăm lần trở lên |
Một biến không có một chỗ ở cố định. Nó là cái nhãn, được dịch thành địa chỉ ảo, rồi thành ô RAM thật, rồi được sao lên cache và thanh ghi mỗi khi CPU cần.
Hiểu chỗ ở của biến giúp gì khi viết code?
Kiến thức này không chỉ để trả lời phỏng vấn. Nó giải thích nhiều chuyện bạn gặp hằng ngày:
-
Lỗi stack overflow khi đệ quy quá sâu: đổi sang vòng lặp hoặc tự quản lý ngăn xếp trên heap.
-
Con trỏ treo (dangling pointer) khi trả về địa chỉ biến cục bộ: dữ liệu cần sống lâu thì cấp trên heap.
-
Memory leak khi quên giải phóng: dùng smart pointer trong C++, hoặc để GC lo nếu ngôn ngữ có.
-
Code chậm bất thường khi duyệt dữ liệu rải rác: xếp dữ liệu liền nhau để tận dụng cache line.
-
Lỗi đọc file nhị phân sai số: kiểm tra endian.
-
[ ] Thử in địa chỉ của một biến cục bộ, một biến toàn cục và một vùng
mallocđể thấy ba khu khác nhau -
[ ] Chạy
ulimit -sđể xem giới hạn stack trên máy bạn -
[ ] Biên dịch với
-O0và-O2, so sánh mã máy bằngobjdump -d
Tóm tắt nhanh
- RAM là một dãy ô 1 byte, mỗi ô có địa chỉ; 16 GB tương đương khoảng 17 tỷ ô.
- Tên biến bị compiler xoá sạch, thay bằng địa chỉ;
intchiếm 4 byte, xếp theo little endian trên x86 và ARM. - Biến cục bộ nằm trên stack (nhanh, nhỏ, tự dọn), dữ liệu động nằm trên heap (lớn, sống lâu, phải tự trả), biến toàn cục và hằng số nằm ở vùng tĩnh.
- Địa chỉ bạn thấy là địa chỉ ảo; MMU dịch sang địa chỉ vật lý qua bảng trang 4 KB.
- Khi tính toán, biến được sao lên cache và thanh ghi; biến nhỏ có thể chỉ sống trong thanh ghi.
Câu hỏi thường gặp
Con trỏ chiếm bao nhiêu byte?
Trên hệ 64-bit, con trỏ chiếm 8 byte bất kể nó trỏ tới char hay một struct khổng lồ. Trên hệ 32-bit, con trỏ chiếm 4 byte, nên mỗi chương trình chỉ đánh địa chỉ được tối đa 4 GB.
Python hay JavaScript có stack và heap không?
Có. Bản thân trình thông dịch hoặc máy ảo chạy trên stack và heap như mọi chương trình. Các đối tượng bạn tạo (list, object, chuỗi) gần như đều nằm trên heap và do garbage collector quản lý; biến của bạn thực chất giữ tham chiếu tới chúng.
Vì sao in địa chỉ cùng một biến, mỗi lần chạy lại ra số khác?
Do ASLR: hệ điều hành xáo ngẫu nhiên vị trí stack, heap và thư viện mỗi lần chạy để chống tấn công. Hơn nữa đó là địa chỉ ảo, nên dù số giống nhau cũng chưa chắc cùng một ô RAM thật.
Stack nhanh hơn heap bao nhiêu?
Không có một con số cố định. Cấp phát trên stack chỉ là dịch một thanh ghi, gần như không tốn gì; cấp phát trên heap phải tìm chỗ trống và ghi sổ sách nên tốn hơn hẳn. Còn khi đã có dữ liệu, đọc ghi ở hai nơi tốc độ tương đương, quyết định chủ yếu nằm ở việc dữ liệu có sẵn trong cache hay không.