Bạn bỏ tiền mua một con CPU đời mới nhất, nhiều nhân, xung nhịp cao ngất, rồi tải thử một mô hình AI về máy chạy. Kết quả: chữ hiện ra lạch cạch từng từ một, quạt gào như máy sấy tóc. Trong khi đó, một chiếc máy cấu hình tầm trung nhưng có card đồ hoạ rời lại trả lời trôi tuột. Vì sao một con chip vốn sinh ra để chơi game lại trở thành "trái tim" của cả ngành AI? Bài này đi từ phép toán nhỏ nhất bên trong mạng nơ-ron cho tới chuyện bộ nhớ và phần mềm, để bạn hiểu tận gốc.
AI thực chất chỉ làm một phép toán, nhưng làm hàng tỷ lần
Nghe "trí tuệ nhân tạo" thì tưởng phức tạp, nhưng nếu mổ xẻ một mạng nơ-ron ra, việc nó làm nhiều nhất lại cực kỳ đơn giản: nhân hai con số rồi cộng dồn kết quả. Dân kỹ thuật gọi là phép MAC (multiply–accumulate). Mỗi "nơ-ron" nhận vào một dãy số, nhân từng số với một trọng số (tham số) tương ứng, cộng tất cả lại, rồi chuyển kết quả sang lớp tiếp theo.
Gom hàng nghìn nơ-ron như thế thành một lớp, thì phép tính của cả lớp chính là nhân ma trận: một ma trận đầu vào nhân với một ma trận trọng số. Toàn bộ quá trình "suy nghĩ" của mô hình ngôn ngữ, nhận diện ảnh hay tạo ảnh, về bản chất là một chuỗi phép nhân ma trận nối tiếp nhau.
Cái khó không nằm ở độ khó của phép tính, mà ở số lượng. Một quy tắc ước lượng phổ biến: với mô hình ngôn ngữ, mỗi tham số tốn khoảng 2 phép tính (một nhân, một cộng) cho mỗi token được sinh ra. Vậy:
| Mô hình | Phép tính cho 1 token | Cho đoạn 100 token |
|---|---|---|
| 7 tỷ tham số | khoảng 14 tỷ | khoảng 1.400 tỷ |
| 13 tỷ tham số | khoảng 26 tỷ | khoảng 2.600 tỷ |
| 70 tỷ tham số | khoảng 140 tỷ | khoảng 14.000 tỷ |
Chỉ để viết một đoạn văn ngắn, máy đã phải làm hơn một nghìn tỷ phép nhân–cộng. Đó là lý do câu hỏi "chip nào nhanh hơn" trong AI thực ra là câu hỏi "chip nào làm được nhiều phép tính đơn giản cùng lúc hơn".
CPU: một nhóm nhỏ giáo sư giỏi
CPU được thiết kế cho kiểu công việc hoàn toàn khác: chạy hệ điều hành, trình duyệt, Excel, game logic… Những việc này đầy rẫy rẽ nhánh ("nếu A thì làm B, không thì làm C"), phụ thuộc lẫn nhau, bước sau phải chờ kết quả bước trước. Để làm tốt, mỗi nhân CPU được nhồi rất nhiều "chất xám": bộ dự đoán rẽ nhánh, khả năng thực thi lệnh không theo thứ tự, bộ nhớ đệm (cache) lớn, xung nhịp cao.
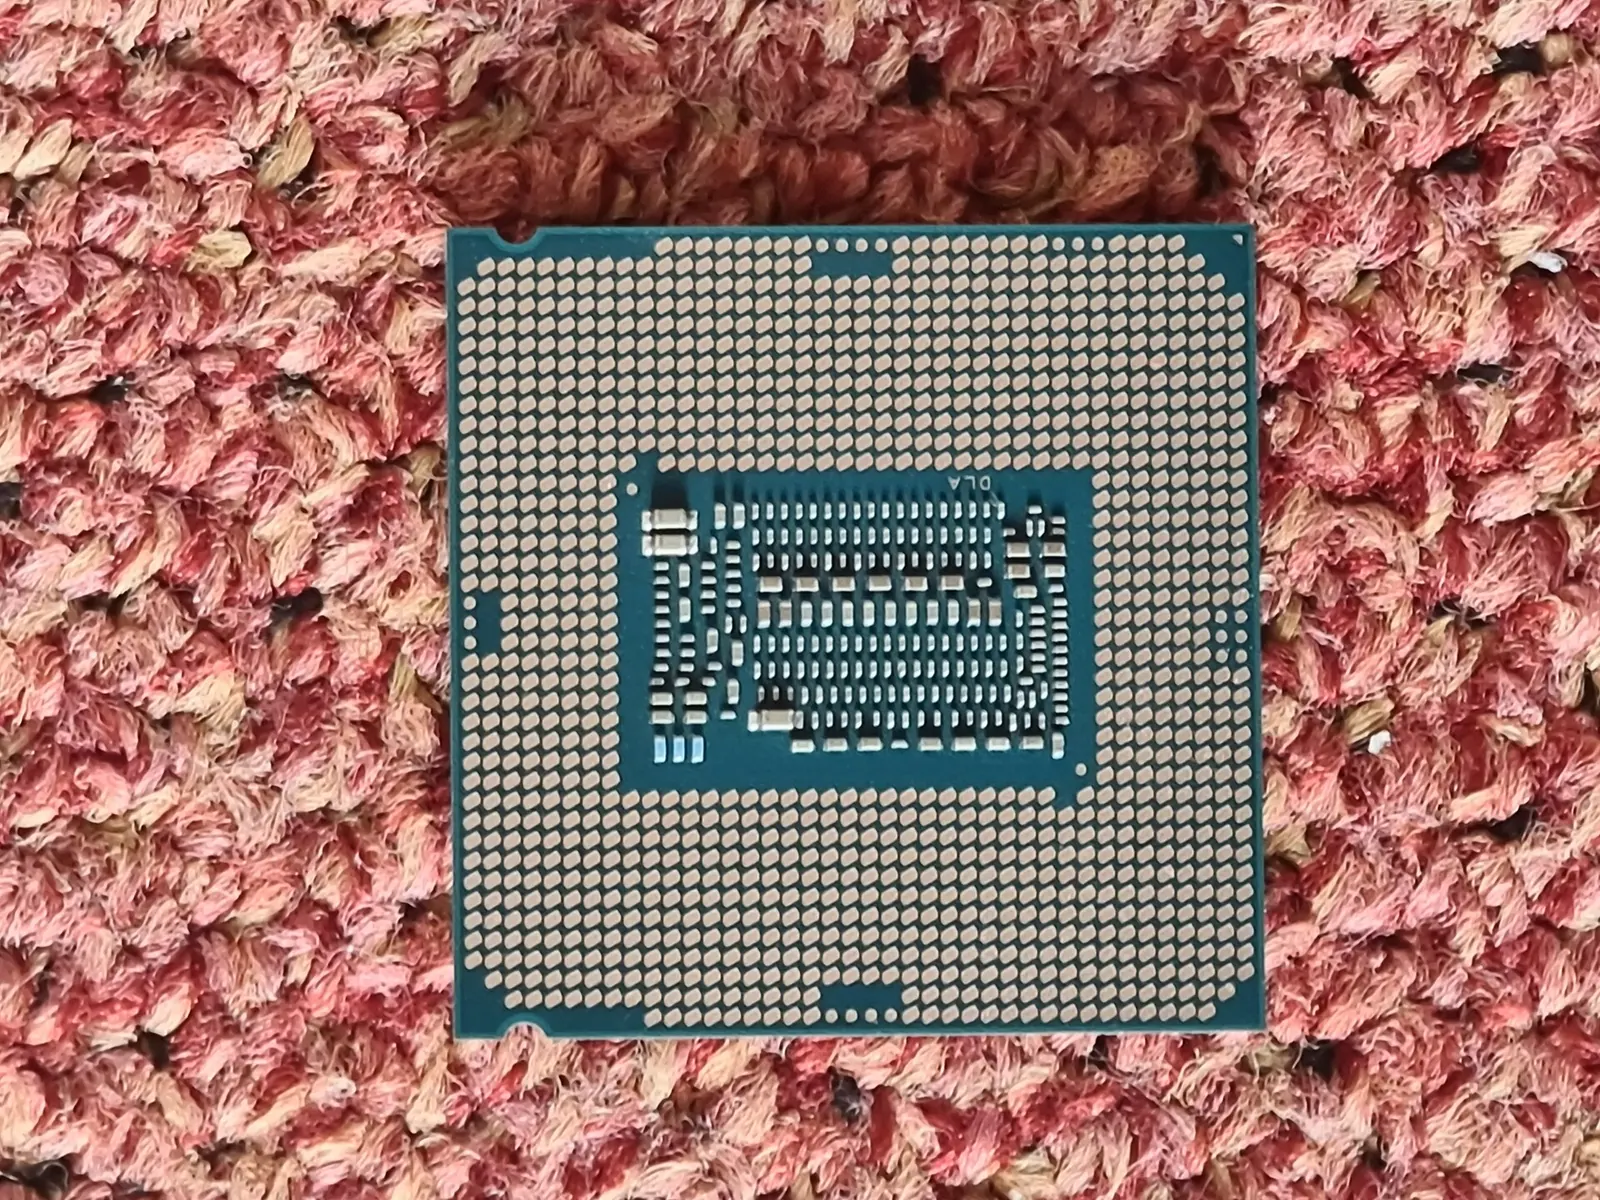
Hệ quả là mỗi nhân rất to và tốn diện tích silicon, nên một con CPU phổ thông chỉ có khoảng 8 đến 24 nhân. Mỗi nhân xử lý một luồng việc phức tạp cực nhanh, nhưng số lượng thì ít. Hình dung CPU như một nhóm nhỏ giáo sư đại học: ai cũng giỏi, giải được bài khó, nhưng chỉ có vài người.
CPU hiện đại cũng có tập lệnh vector (AVX2, AVX-512) cho phép một nhân xử lý vài chục con số trong một lệnh. Nhờ đó CPU vẫn chạy được AI, chỉ là so với GPU thì chênh lệch về quy mô quá lớn.
GPU: đội quân hàng nghìn học sinh tiểu học
GPU ra đời để vẽ hình 3D cho game. Một khung hình Full HD có hơn 2 triệu điểm ảnh, và màu của từng điểm được tính bằng cùng một công thức, độc lập với các điểm khác. Đây là bài toán "nhiều việc giống nhau, không ai phải chờ ai", nên các kỹ sư thiết kế GPU theo hướng ngược hẳn CPU: bỏ bớt sự thông minh của từng nhân, đổi lấy số lượng nhân khổng lồ.
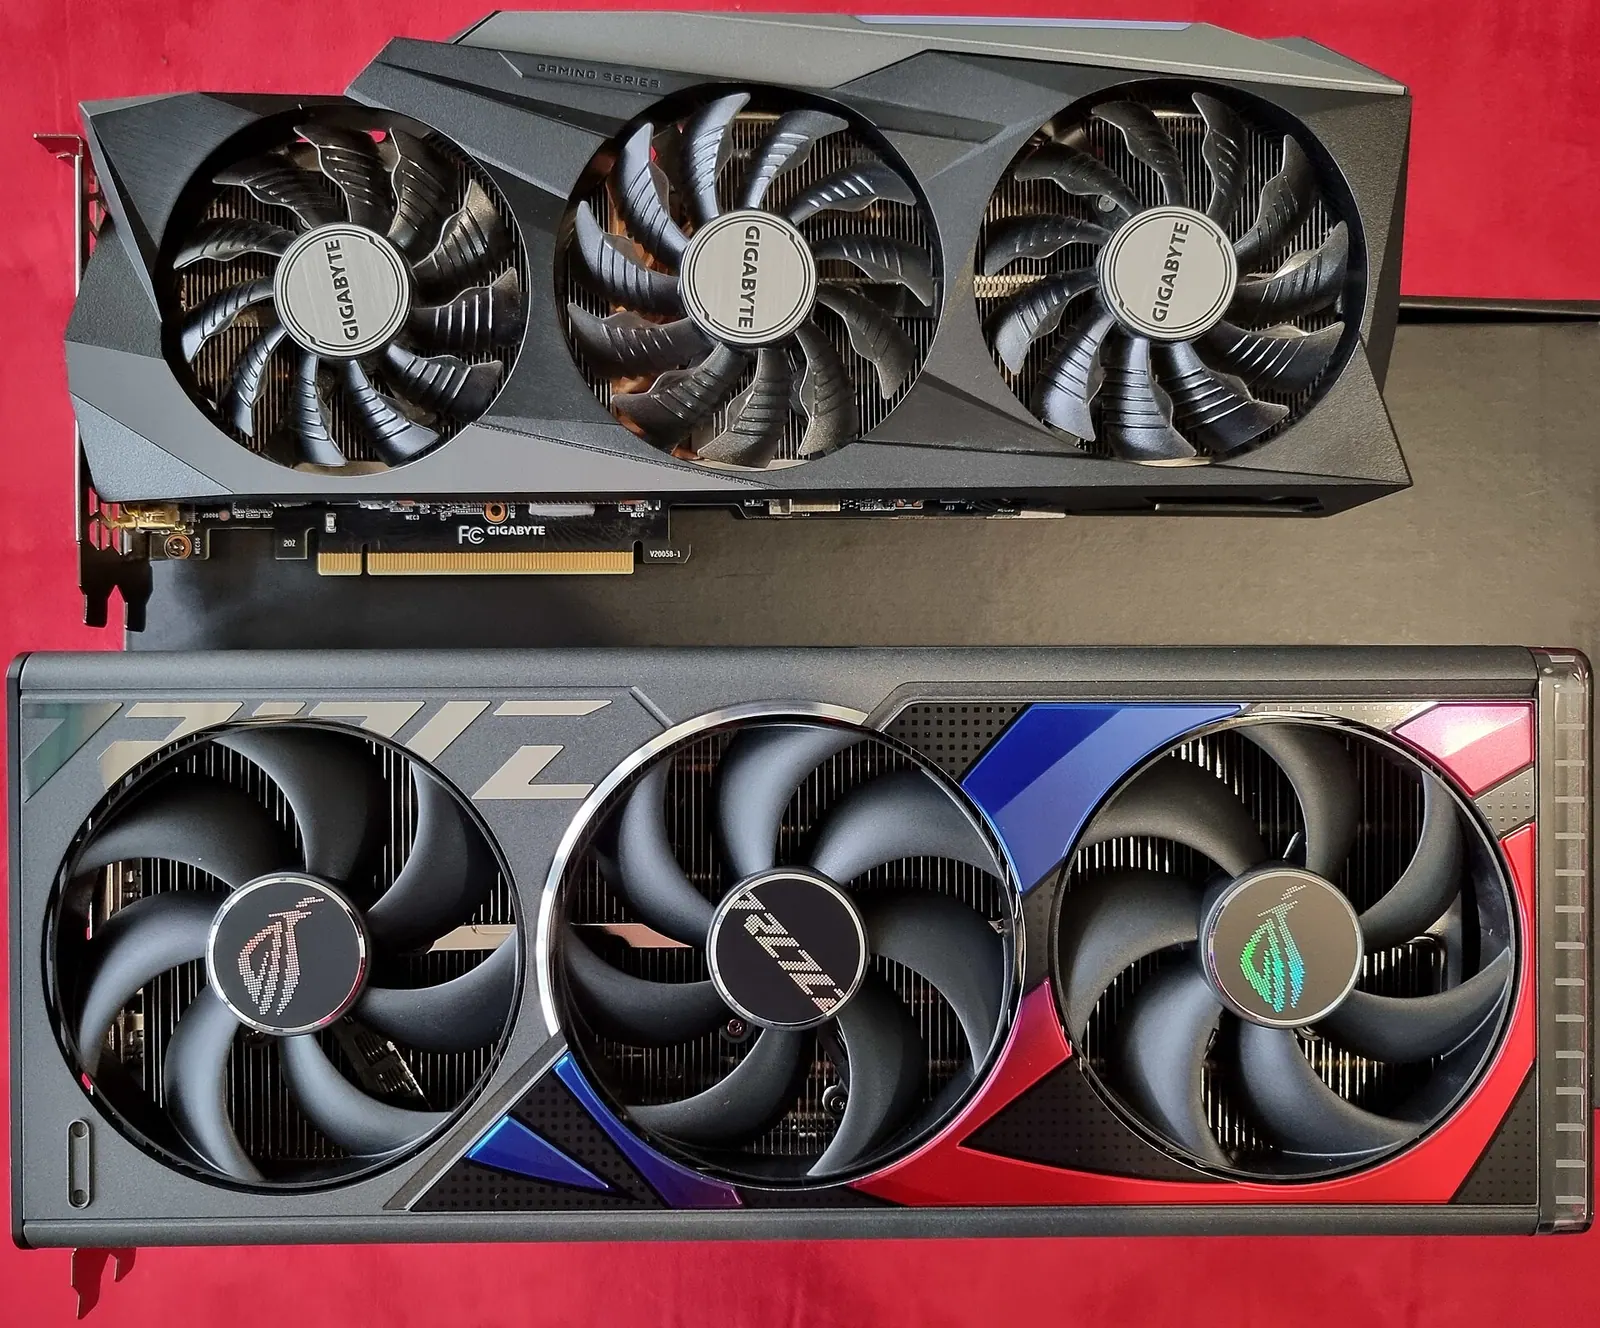
Lấy ví dụ GeForce RTX 4090: con chip này có 16.384 nhân CUDA. Mỗi nhân đơn giản, xung nhịp thấp hơn nhân CPU, không giỏi rẽ nhánh. Nhưng chúng được tổ chức thành từng nhóm cùng thực thi một lệnh trên nhiều dữ liệu khác nhau, nên khi bài toán chia nhỏ được, cả đội quân cùng làm một lúc.
| Tiêu chí | CPU phổ thông | GPU (ví dụ RTX 4090) |
|---|---|---|
| Số nhân | 8–24 | 16.384 nhân CUDA |
| Sức mạnh mỗi nhân | Rất mạnh, xử lý logic phức tạp | Yếu, chỉ giỏi tính toán đơn giản |
| Giỏi nhất ở | Việc tuần tự, nhiều rẽ nhánh | Việc lặp lại, chia nhỏ được |
| Bộ nhớ đi kèm | RAM hệ thống | VRAM riêng, băng thông rất cao |
Ví dụ chấm bài: vì sao xử lý song song thắng
Hình dung bạn cần chấm 10.000 bài trắc nghiệm. Phương án A: thuê 8 giáo sư, mỗi người chấm từng bài. Dù giáo sư chấm nhanh gấp mấy lần học sinh, mỗi người vẫn phải ôm 1.250 bài. Phương án B: gọi 1.000 học sinh tiểu học, đưa đáp án cho mỗi em, mỗi em chấm 10 bài. Chấm trắc nghiệm chỉ là so đáp án, không cần trình độ giáo sư, nên phương án B xong trước rất xa.
Phép nhân ma trận trong AI chính là kiểu "chấm trắc nghiệm" này. Mỗi ô trong ma trận kết quả là tổng các tích của một hàng nhân một cột, và việc tính ô này không cần chờ ô bên cạnh. Một ma trận 4.096 × 4.096 có hơn 16 triệu ô kết quả, đều tính độc lập được. GPU chia nhỏ chúng cho hàng nghìn nhân xử lý cùng lúc, còn CPU phải xoay vòng qua vài chục nhân.
Với việc tuần tự, bước sau phụ thuộc bước trước (biên dịch code, xử lý logic game, nén file), GPU gần như vô dụng vì hàng nghìn nhân chỉ ngồi chờ nhau. Đó là lý do máy tính nào cũng vẫn cần CPU, GPU chỉ là "đội tăng cường" cho đúng loại việc nó giỏi.
Tensor Core: mạch chuyên dụng chỉ để nhân ma trận
Nếu chỉ có nhân CUDA, GPU đã nhanh hơn CPU nhiều lần. Nhưng từ thế hệ Volta (năm 2017), Nvidia thêm một loại mạch mới tên Tensor Core, sinh ra chỉ để làm đúng một việc: nhân ma trận.
Khác biệt nằm ở đơn vị công việc. Một nhân thường mỗi nhịp xử lý một phép nhân–cộng trên từng cặp số. Tensor Core thì mỗi nhịp nhân cả một khối ma trận nhỏ (ví dụ 4×4) với một khối khác rồi cộng dồn, tức là hàng chục phép nhân–cộng gói gọn trong một bước. Thêm vào đó, Tensor Core làm việc với các định dạng số "nhẹ" như FP16, BF16, FP8, INT8, vốn đủ chính xác cho AI nhưng tốn ít mạch và ít bộ nhớ hơn số thực 32 bit.
Kết quả là với khối lượng nhân ma trận, Tensor Core cho thông lượng cao hơn nhân CUDA thường nhiều lần. Ngày nay mọi GPU Nvidia từ dòng RTX cho tới card trung tâm dữ liệu đều có Tensor Core, và các thư viện AI tự động dùng nó khi bạn chạy mô hình ở độ chính xác thấp.
Khi so sánh card cho AI, đừng chỉ nhìn số nhân CUDA. Thế hệ Tensor Core và việc card có hỗ trợ các định dạng như BF16 hay FP8 hay không ảnh hưởng rất lớn tới tốc độ thực tế.
Nút thắt thứ hai: bộ nhớ phải chạy đủ nhanh
Có hàng nghìn nhân tính toán mà dữ liệu đến chậm thì cũng như có 1.000 học sinh nhưng chỉ một người phát bài: cả lớp ngồi chờ. Với mô hình ngôn ngữ, đây mới thực sự là nút thắt. Mỗi khi sinh một token, máy phải đọc toàn bộ tham số của mô hình từ bộ nhớ lên chip tính toán.
So sánh băng thông bộ nhớ (lượng dữ liệu đọc được mỗi giây):
| Loại bộ nhớ | Băng thông xấp xỉ |
|---|---|
| RAM DDR5 kênh đôi trên PC | khoảng 80 GB/s |
| VRAM GDDR6X trên RTX 4090 | khoảng 1.000 GB/s |
| HBM3 trên GPU trung tâm dữ liệu H100 | hơn 3.000 GB/s |
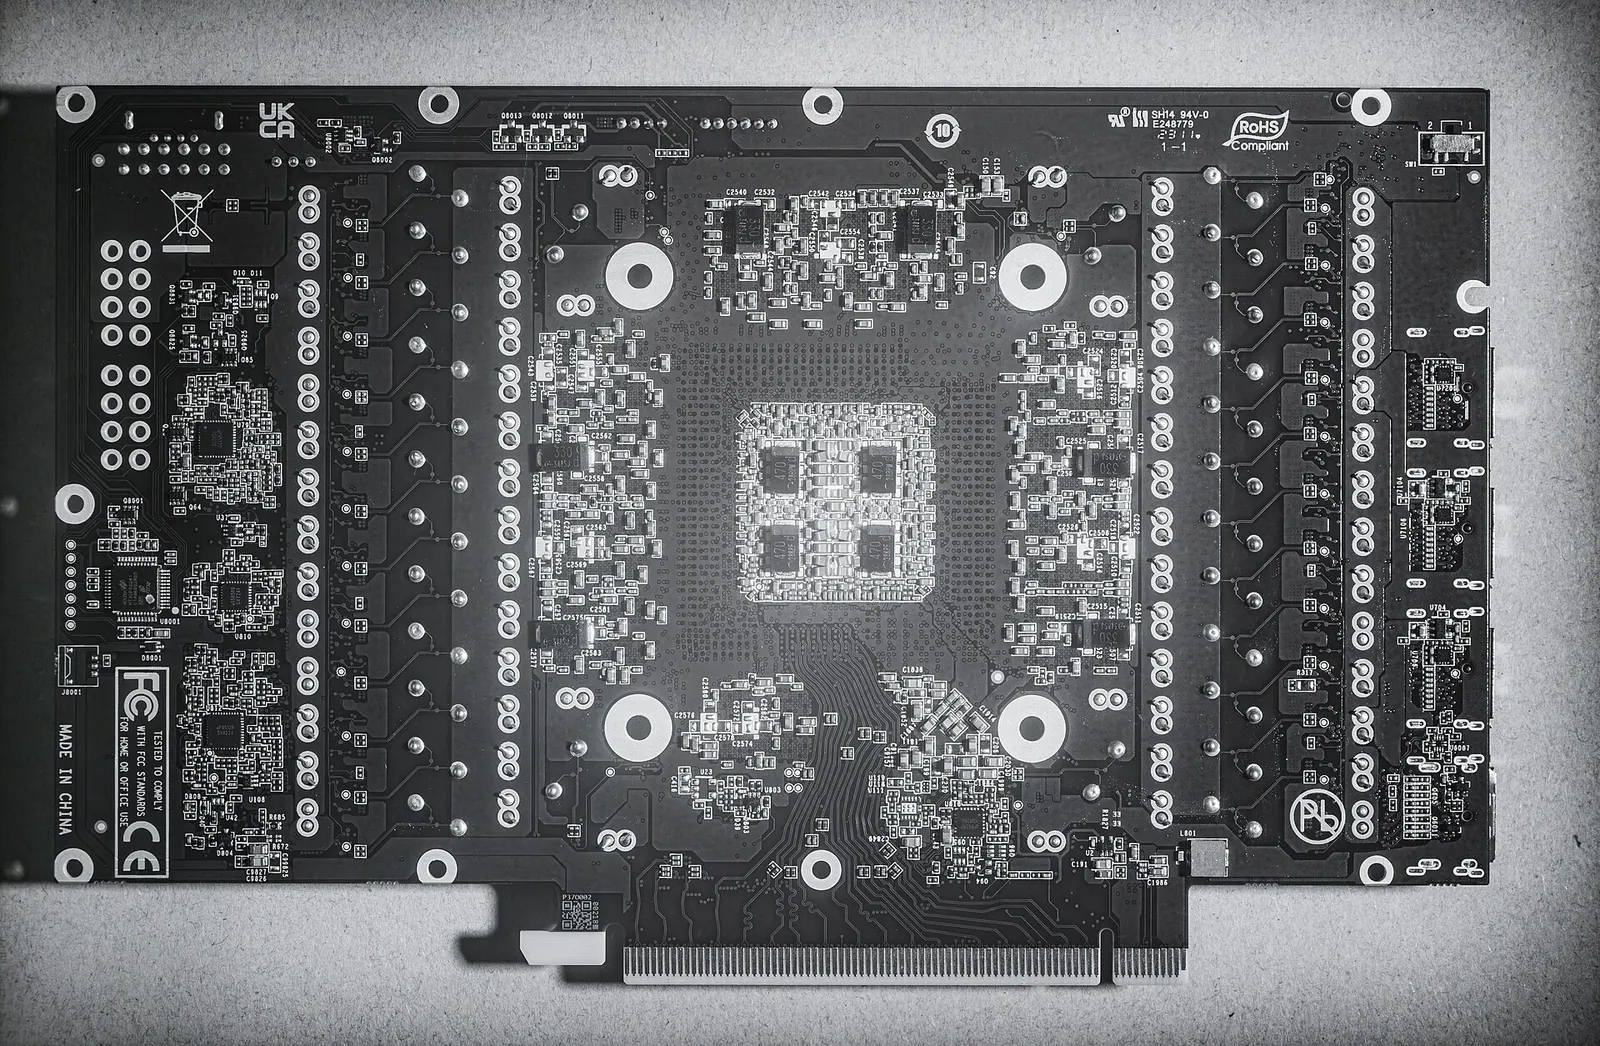
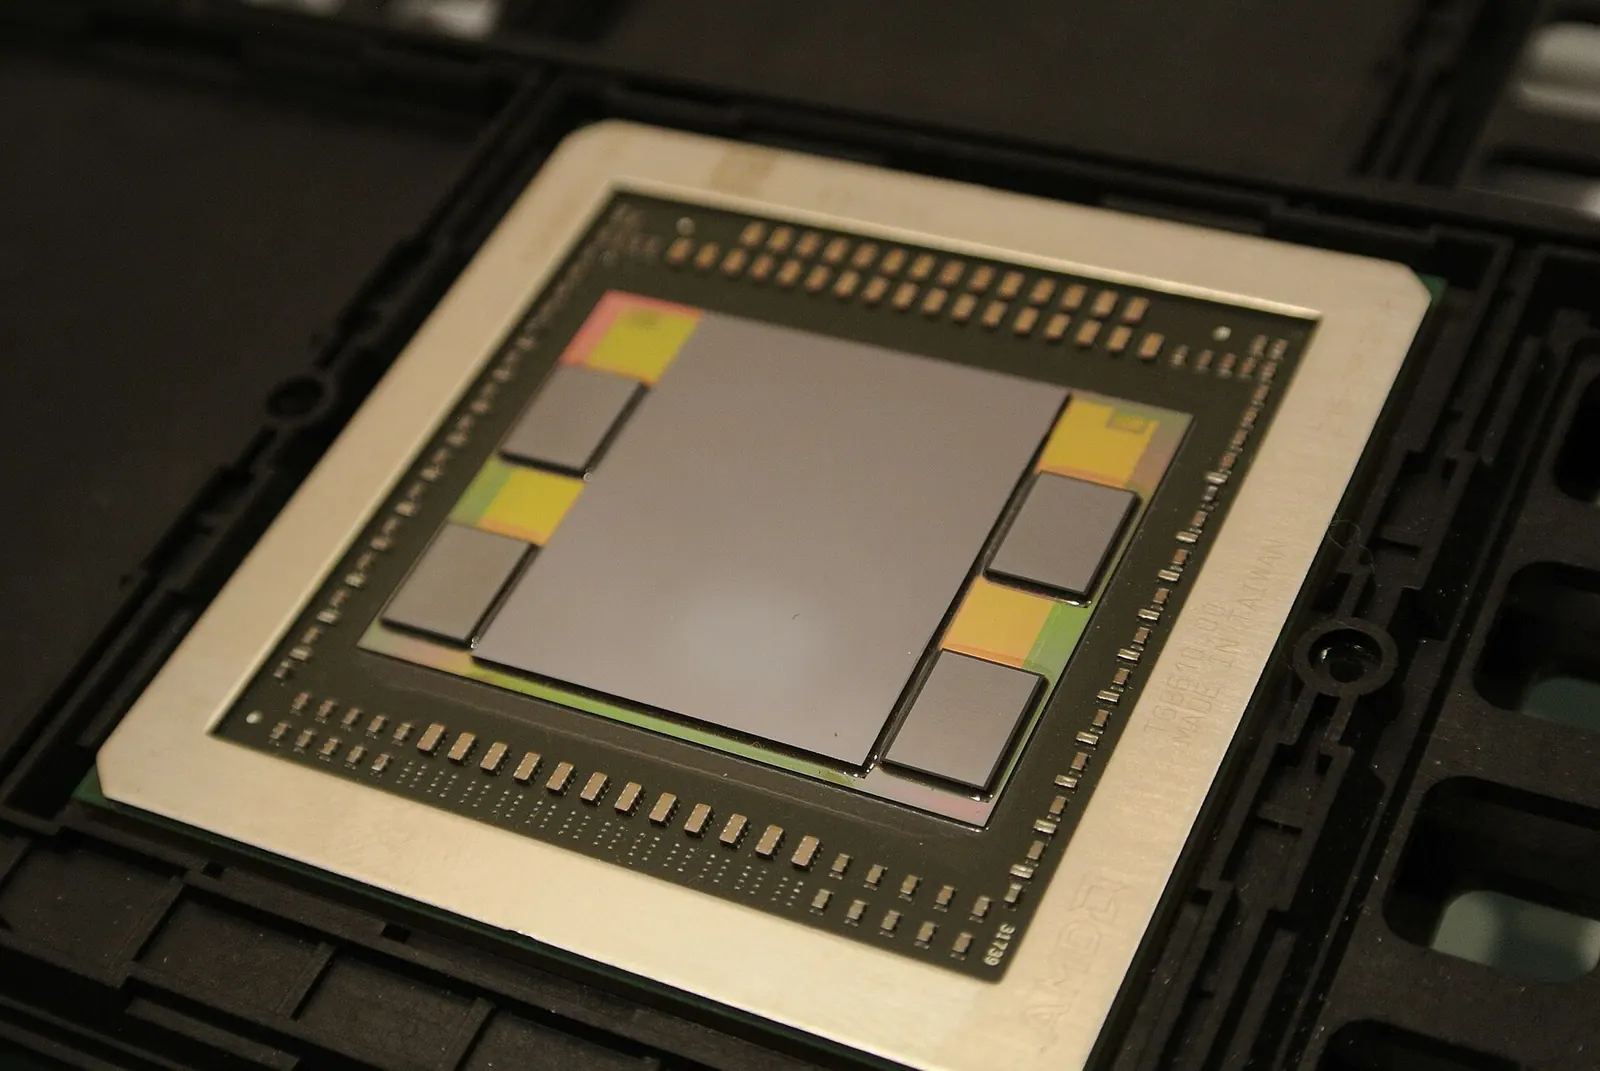
VRAM nhanh như vậy vì được hàn sát ngay cạnh chip GPU, đi qua bus dữ liệu rất rộng (384 bit trên RTX 4090) và chạy ở tốc độ truyền cao. Còn HBM đi xa hơn nữa: các lớp chip nhớ được xếp chồng theo chiều dọc và đặt ngay trên cùng một đế với GPU, nối bằng hàng nghìn đường dẫn, nên băng thông vọt lên mức terabyte mỗi giây.
Một phép tính nháp cho dễ hình dung: mô hình 7 tỷ tham số nén 4 bit nặng khoảng 4 GB. Nếu mỗi token phải đọc hết 4 GB đó, thì với RAM 80 GB/s, trần lý thuyết chỉ khoảng 20 token mỗi giây; với VRAM 1.000 GB/s, trần lý thuyết lên tới khoảng 250 token mỗi giây. Thực tế thấp hơn trần này, nhưng tỷ lệ chênh lệch thì giữ nguyên. Băng thông bộ nhớ gần như quyết định tốc độ "gõ chữ" của chatbot chạy tại nhà.
Kết quả thực tế: từ vài tuần xuống vài giờ
Cộng ba yếu tố lại (hàng nghìn nhân song song, Tensor Core, bộ nhớ siêu nhanh), chênh lệch giữa CPU và GPU trong AI thường ở mức hàng chục, thậm chí hàng trăm lần tuỳ bài toán. Huấn luyện một mô hình nhận diện ảnh trên CPU có thể mất vài tuần, trên GPU chỉ còn vài giờ.
Bước ngoặt lịch sử thường được nhắc tới là năm 2012, khi mạng AlexNet thắng áp đảo cuộc thi nhận diện ảnh ImageNet. Nhóm tác giả huấn luyện nó trên hai card GTX 580 chơi game trong khoảng năm đến sáu ngày, khối lượng tính toán mà CPU thời đó khó kham nổi trong thời gian hợp lý. Từ đó, GPU trở thành tiêu chuẩn của ngành.
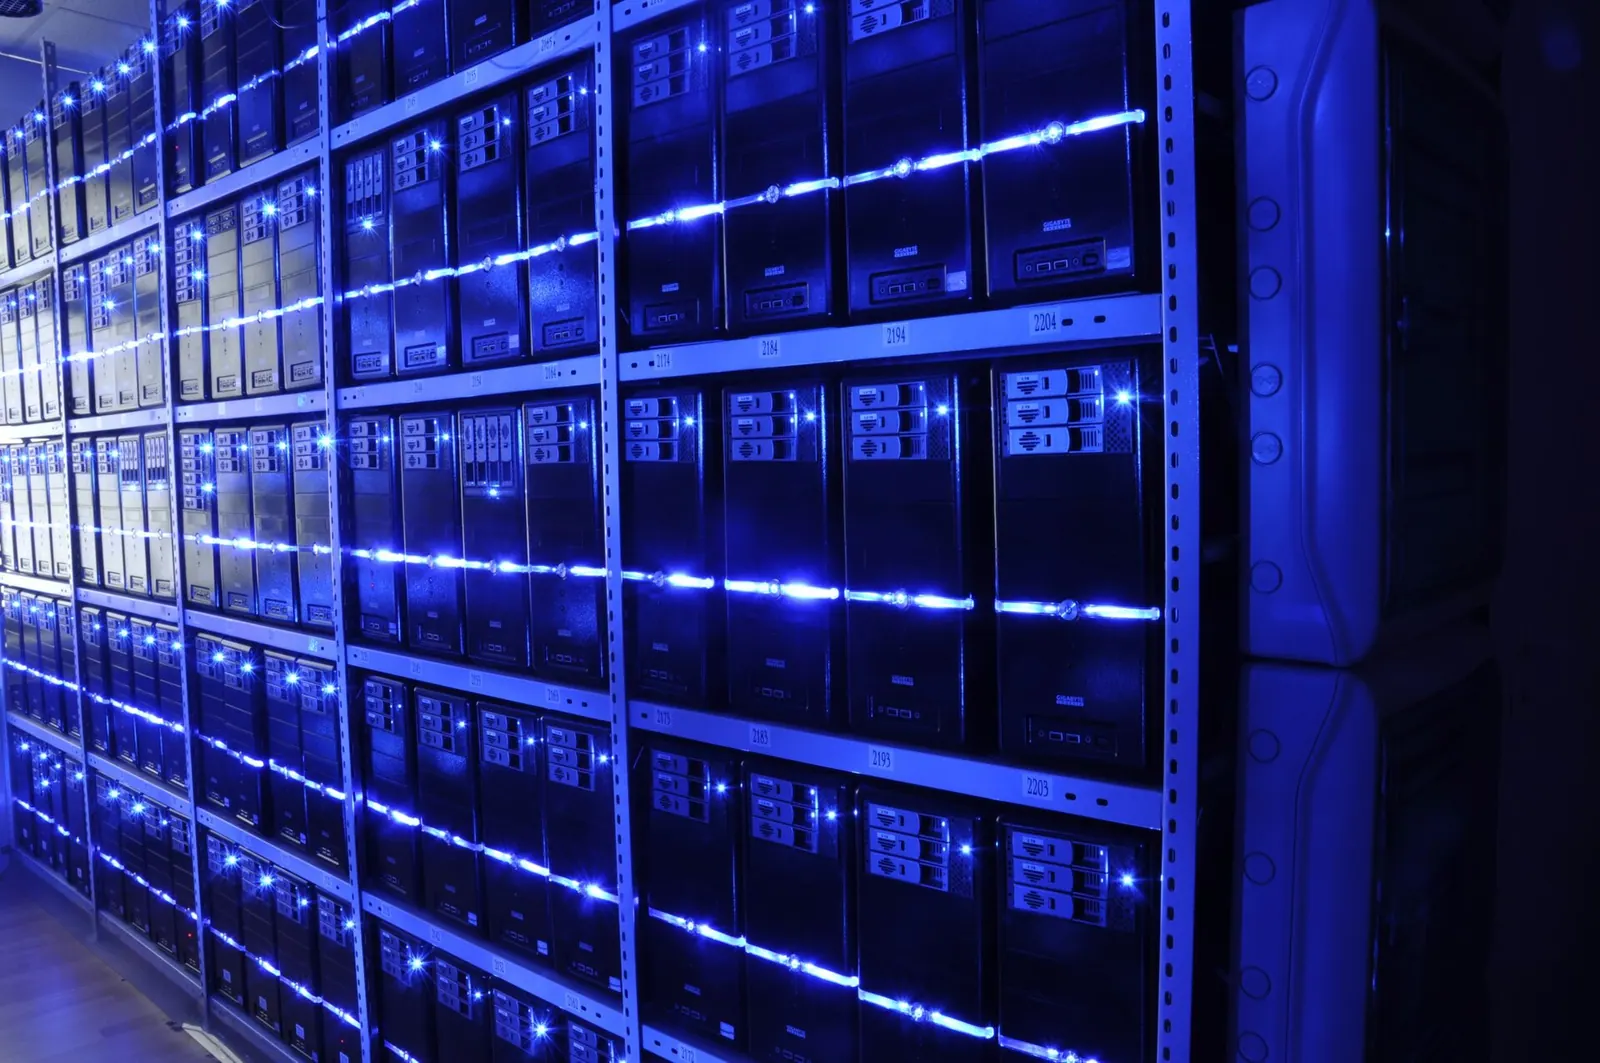
Ngày nay, những mô hình lớn như chatbot bạn dùng hằng ngày được huấn luyện trên hàng chục nghìn GPU chạy cùng lúc trong các trung tâm dữ liệu khổng lồ.
Lý do thứ ba ít ai để ý: phần mềm
Phần cứng mạnh chưa đủ. Nvidia ra mắt nền tảng lập trình CUDA từ năm 2007, cho phép lập trình viên dùng GPU cho tính toán tổng quát chứ không chỉ vẽ hình. Gần hai thập kỷ sau, các thư viện AI phổ biến như PyTorch và TensorFlow đều được tối ưu sẵn cho CUDA, kèm các thư viện chuyên dụng như cuDNN, cuBLAS. Đây là "con hào" khiến GPU Nvidia chiếm ưu thế: AMD có ROCm, Intel có oneAPI, nhưng độ phủ và độ chín của hệ sinh thái vẫn còn khoảng cách.
Kiểm tra nhanh máy bạn có GPU Nvidia sẵn sàng cho AI hay không:
nvidia-smi
python -c "import torch; print(torch.cuda.is_available())"
Lệnh đầu hiện tên card, dung lượng VRAM, phiên bản driver. Lệnh sau in True nghĩa là PyTorch đã nhận GPU.
Chạy AI tại nhà: cần gì, thiếu GPU thì sao?
Cần bao nhiêu VRAM?
Với người muốn tự chạy mô hình trên máy, dung lượng VRAM quan trọng hơn cả tốc độ chip. Mô hình phải nằm gọn trong VRAM thì mới chạy nhanh; tràn ra RAM là tốc độ rơi tự do vì băng thông tụt cả chục lần như phân tích ở trên.
Cách ước lượng: dung lượng ≈ số tham số × số byte mỗi tham số, cộng thêm phần đệm cho ngữ cảnh hội thoại.
| Mô hình | Độ chính xác | Dung lượng trọng số xấp xỉ | VRAM nên có |
|---|---|---|---|
| 7 tỷ tham số | 16 bit | khoảng 14 GB | 16 GB trở lên |
| 7 tỷ tham số | nén 4 bit | khoảng 4 GB | 8 GB là chạy mượt |
| 13 tỷ tham số | nén 4 bit | khoảng 7 GB | 10–12 GB |
| 70 tỷ tham số | nén 4 bit | khoảng 35–40 GB | 48 GB hoặc nhiều card |
Nhiều người chọn card theo sức mạnh chơi game rồi mới phát hiện VRAM quá ít để nạp mô hình. Với AI, một card yếu hơn nhưng nhiều VRAM thường hữu ích hơn card mạnh nhưng VRAM nhỏ.
Checklist trước khi tự chạy mô hình AI tại nhà:
- [ ]Xem máy có GPU rời không và VRAM bao nhiêu GB
- [ ]Chọn mô hình có bản nén 4 bit vừa với VRAM, chừa 1–2 GB dư
- [ ]Cập nhật driver card đồ hoạ bản mới
- [ ]Dùng công cụ chạy mô hình có hỗ trợ tăng tốc GPU
Không có GPU rời thì có làm AI được không?
Câu trả lời là có, tuỳ bạn làm gì:
- Dùng chatbot trên web hoặc app: mọi tính toán diễn ra trên máy chủ của nhà cung cấp, máy bạn chỉ hiển thị kết quả. Laptop văn phòng hay điện thoại đều dùng tốt.
- Chip Apple dòng M: dùng bộ nhớ hợp nhất, CPU và GPU tích hợp chia chung một vùng RAM có băng thông cao hơn RAM PC thông thường. Máy nhiều RAM có thể nạp được mô hình khá lớn, chạy chậm hơn card rời cao cấp nhưng vẫn dùng được.
- NPU trong laptop đời mới: bộ xử lý thần kinh chuyên cho tác vụ AI nhỏ như xoá phông khi gọi video, khử ồn, nhận diện giọng nói, tiết kiệm điện hơn hẳn GPU.
Nhưng nếu bạn muốn huấn luyện mô hình, tinh chỉnh mô hình, hoặc chạy mô hình lớn với tốc độ cao, GPU rời (hoặc thuê GPU trên đám mây) vẫn là lựa chọn gần như bắt buộc.
GPU không thông minh hơn CPU. Nó chỉ đông hơn, đọc dữ liệu nhanh hơn, và AI tình cờ là đúng loại việc cần đám đông.
Tóm tắt nhanh
- AI về bản chất là nhân ma trận: hàng tỷ phép nhân–cộng đơn giản, độc lập với nhau.
- CPU có ít nhân nhưng mạnh, giỏi việc tuần tự; GPU có hàng nghìn nhân yếu nhưng chạy song song, hợp với nhân ma trận.
- Tensor Core nhân cả khối ma trận mỗi nhịp, tăng tốc thêm nhiều lần so với nhân thường.
- Băng thông bộ nhớ (VRAM, HBM) cao gấp hàng chục lần RAM thường, quyết định tốc độ chạy mô hình ngôn ngữ.
- Hệ sinh thái CUDA và thư viện như PyTorch là lý do thứ ba giúp GPU Nvidia thống trị.
Câu hỏi thường gặp
Card đồ hoạ tích hợp trong CPU có chạy AI được không?
Được với mô hình nhỏ, nhưng card tích hợp dùng chung RAM hệ thống nên bị giới hạn băng thông, tốc độ thường chỉ nhỉnh hơn chạy bằng CPU một chút. Ngoại lệ là chip Apple dòng M, vì bộ nhớ hợp nhất của nó có băng thông cao hơn nhiều.
Nên ưu tiên VRAM hay sức mạnh chip khi mua card cho AI?
Ưu tiên VRAM trước. Mô hình không vừa VRAM thì chip mạnh đến đâu cũng phải chờ dữ liệu từ RAM. Sau khi đủ VRAM, mới so đến thế hệ Tensor Core và băng thông bộ nhớ.
Card AMD có dùng cho AI được không?
Được, AMD có nền tảng ROCm và PyTorch đã hỗ trợ. Tuy nhiên số công cụ, hướng dẫn và thư viện tối ưu sẵn vẫn ít hơn CUDA, nên người mới thường gặp nhiều trục trặc cài đặt hơn.
Dùng chatbot trên web có cần máy mạnh không?
Không. Toàn bộ tính toán chạy trên máy chủ của nhà cung cấp, máy bạn chỉ cần trình duyệt và kết nối mạng ổn định.