Bạn gọi video giữa quán cà phê: máy xay sinh tố rít lên, xe máy bóp còi ngoài đường, bàn bên cạnh cười nói rôm rả. Vậy mà người ở đầu bên kia chỉ nghe thấy giọng bạn, gần như không lẫn chút tạp âm nào. Thứ làm được điều đó là Noise Suppression (khử tiếng ồn), một chuỗi xử lý tín hiệu chạy âm thầm trong điện thoại, laptop và các ứng dụng họp trực tuyến. Bài này đi từng bước xem nó làm việc ra sao, vì sao cách cũ thất bại, AI đã thay đổi cuộc chơi thế nào và khi nào bạn nên tắt nó đi.
Noise Suppression khác gì chống ồn chủ động (ANC)?
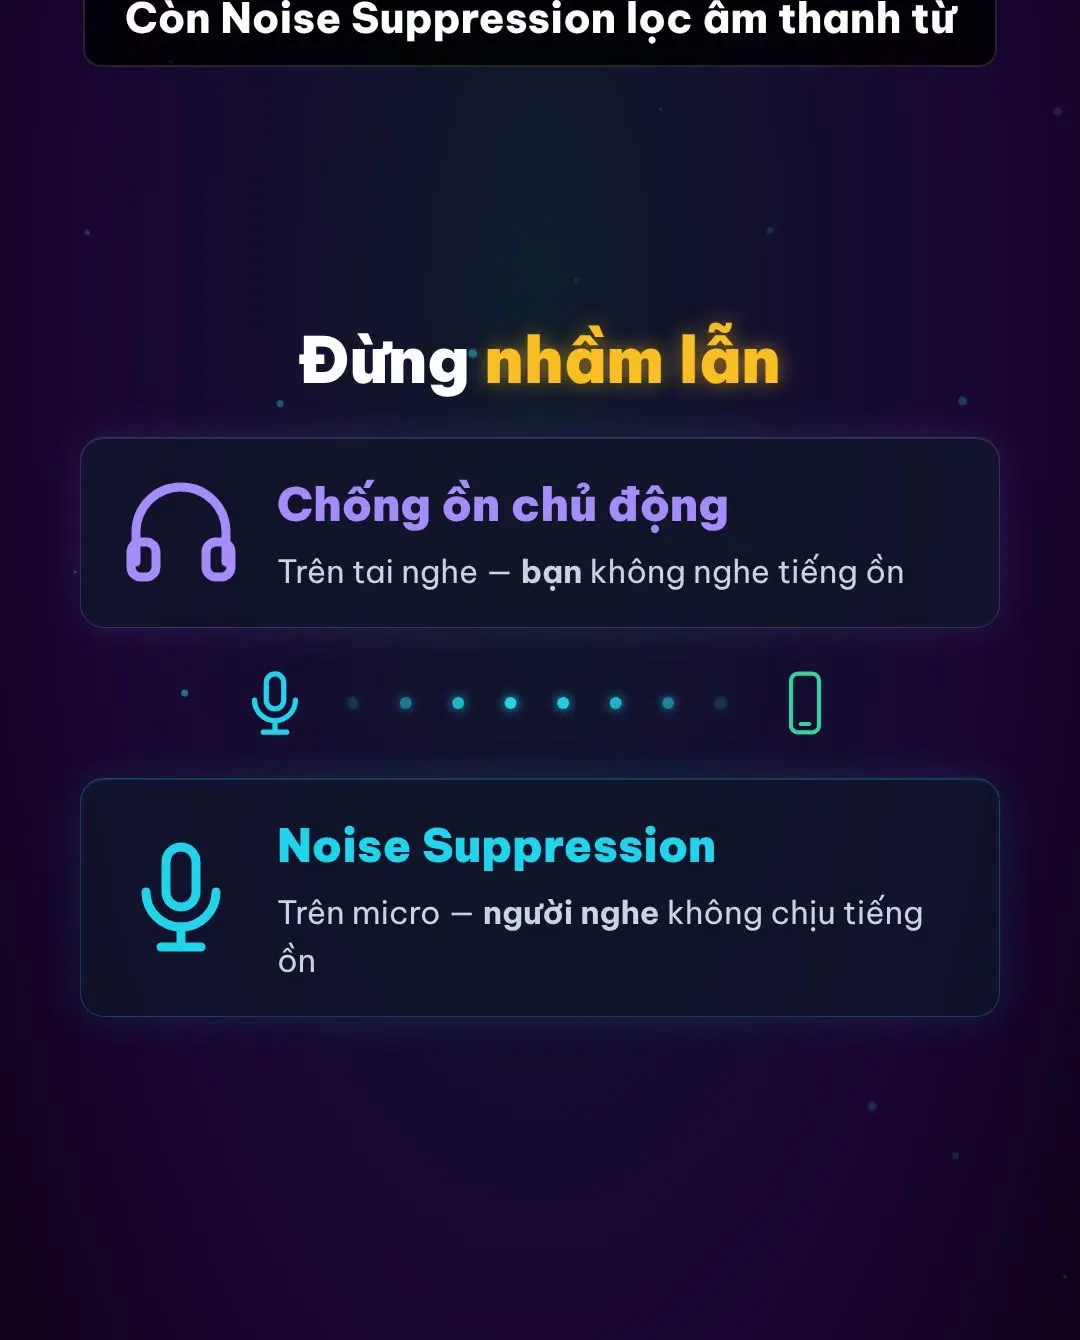
Hai khái niệm này hay bị gọi chung là "chống ồn", nhưng chúng giải quyết hai bài toán ngược chiều nhau.
- Chống ồn chủ động (ANC) nằm trên tai nghe. Micro bên ngoài thu tiếng ồn xung quanh, mạch xử lý phát ra một sóng âm ngược pha để triệt tiêu nó ngay trong tai bạn. Mục đích: bạn không nghe thấy tiếng ồn.
- Noise Suppression xử lý tín hiệu từ micro của bạn trước khi gửi đi. Mục đích: người nghe ở đầu bên kia không phải chịu tiếng ồn quanh bạn.
| Tiêu chí | Chống ồn chủ động (ANC) | Noise Suppression |
|---|---|---|
| Bảo vệ ai | Người đeo tai nghe | Người nghe ở đầu bên kia |
| Xử lý ở đâu | Âm thanh phát vào tai | Âm thanh thu từ micro |
| Nguyên lý | Phát sóng ngược pha để triệt tiêu | Phân tích và lọc bỏ thành phần ồn |
| Hiệu quả nhất với | Tiếng ồn tần số thấp, đều (động cơ máy bay) | Cả ồn đều lẫn ồn bất chợt (khi dùng AI) |
Một chiếc tai nghe cao cấp thường có cả hai: ANC cho bạn nghe nhạc yên tĩnh, còn Noise Suppression cho micro đàm thoại.
Bài toán: tách sữa ra khỏi cà phê
Micro không "biết" đâu là giọng người, đâu là tiếng máy xay. Nó chỉ ghi lại dao động áp suất không khí thành một sóng âm duy nhất. Giọng nói và tiếng ồn cộng dồn vào nhau trong từng mẫu tín hiệu, giống như sữa đã khuấy vào cà phê.
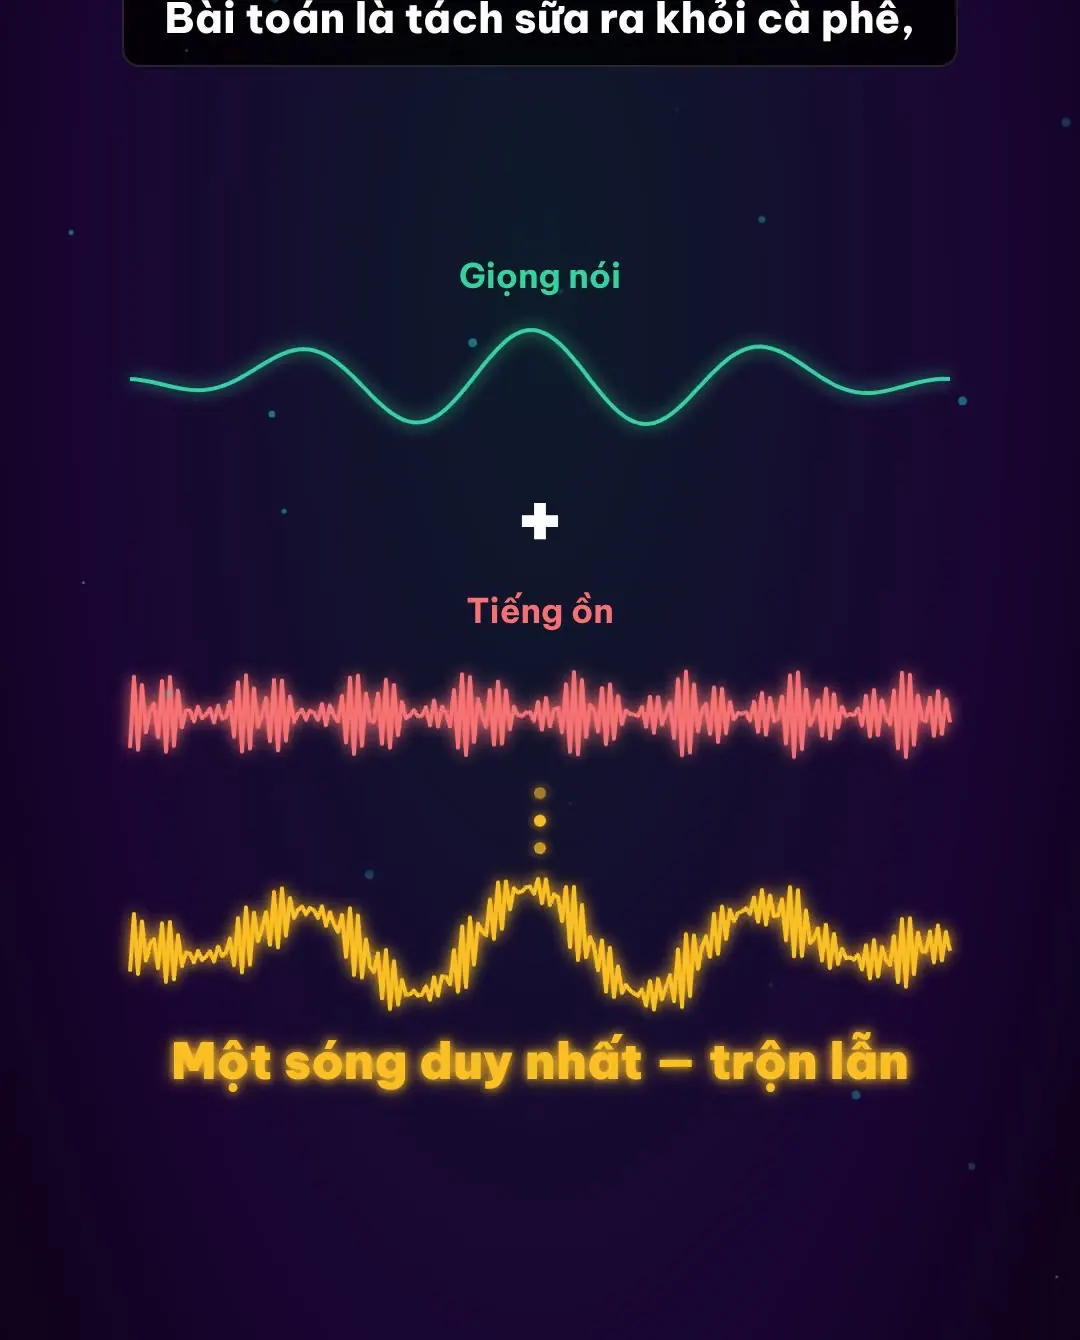
Về mặt toán học, tín hiệu thu được có thể viết là: tín hiệu micro = giọng nói + tiếng ồn. Ta chỉ có vế trái, và phải đoán ra phần giọng nói. Đây là bài toán thiếu dữ kiện: có vô số cách chia một tổng thành hai số hạng. Vì thế mọi thuật toán khử ồn đều phải dựa vào giả định hoặc kiến thức đã học về giọng người và tiếng ồn trông như thế nào. Chất lượng của giả định đó quyết định thuật toán tốt hay dở.
Điều khó hơn nữa là phải làm việc này theo thời gian thực. Bạn không thể đợi nói xong cả câu rồi mới lọc, vì cuộc gọi sẽ trễ không chịu nổi.
Bước 1: Cắt âm thanh thành khung rất ngắn
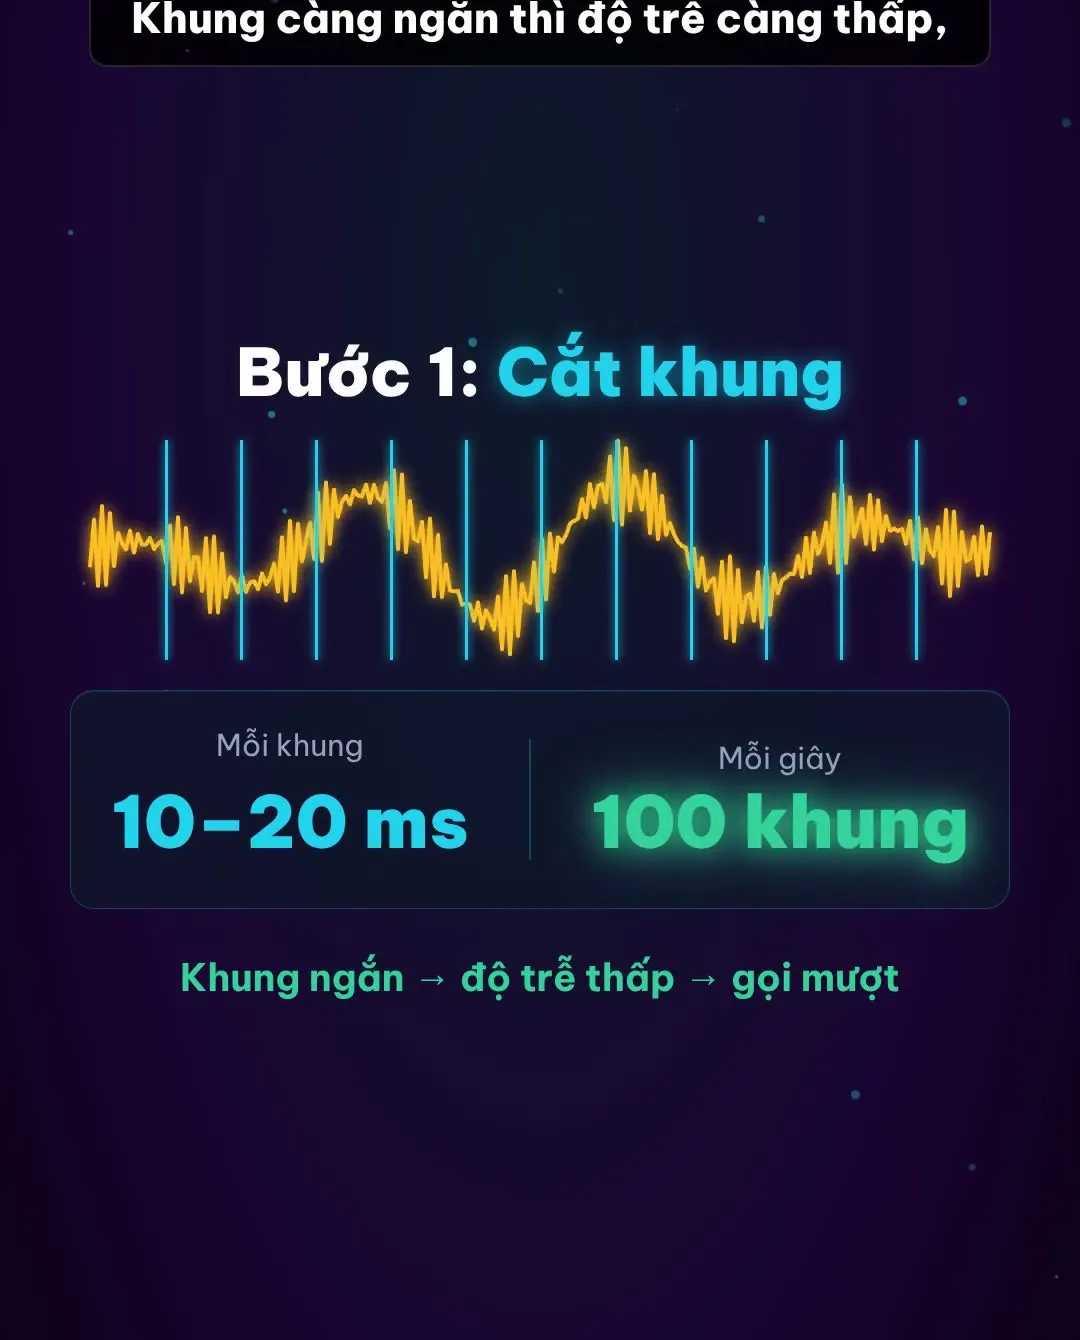
Để xử lý liên tục, máy chia luồng âm thanh thành những khung (frame) dài khoảng 10–20 mili giây. Với khung 10 ms, mỗi giây có 100 khung được xử lý lần lượt.
Vì sao lại ngắn như vậy?
- Độ trễ thấp: thuật toán phải chờ đủ một khung mới xử lý được, nên khung càng ngắn thì âm thanh càng sớm tới người nghe.
- Giọng nói gần như "đứng yên" trong khung ngắn: trong vài chục mili giây, khẩu hình miệng thay đổi không đáng kể, nên đặc tính tần số của khung tương đối ổn định và dễ phân tích.
Trên thực tế, các khung thường chồng lên nhau một phần và được nhân với một hàm cửa sổ (window) để làm mềm hai đầu. Nhờ vậy khi ghép lại không có tiếng "tách" ở chỗ nối giữa các khung.
Bước 2: Biến đổi Fourier — nhìn âm thanh dưới dạng phổ
Mỗi khung được đưa qua biến đổi Fourier (cụ thể là FFT, thuật toán tính nhanh). Thay vì nhìn một đường sóng lên xuống theo thời gian, máy nhận được phổ tần số: bao nhiêu năng lượng nằm ở từng dải tần, từ trầm đến bổng.
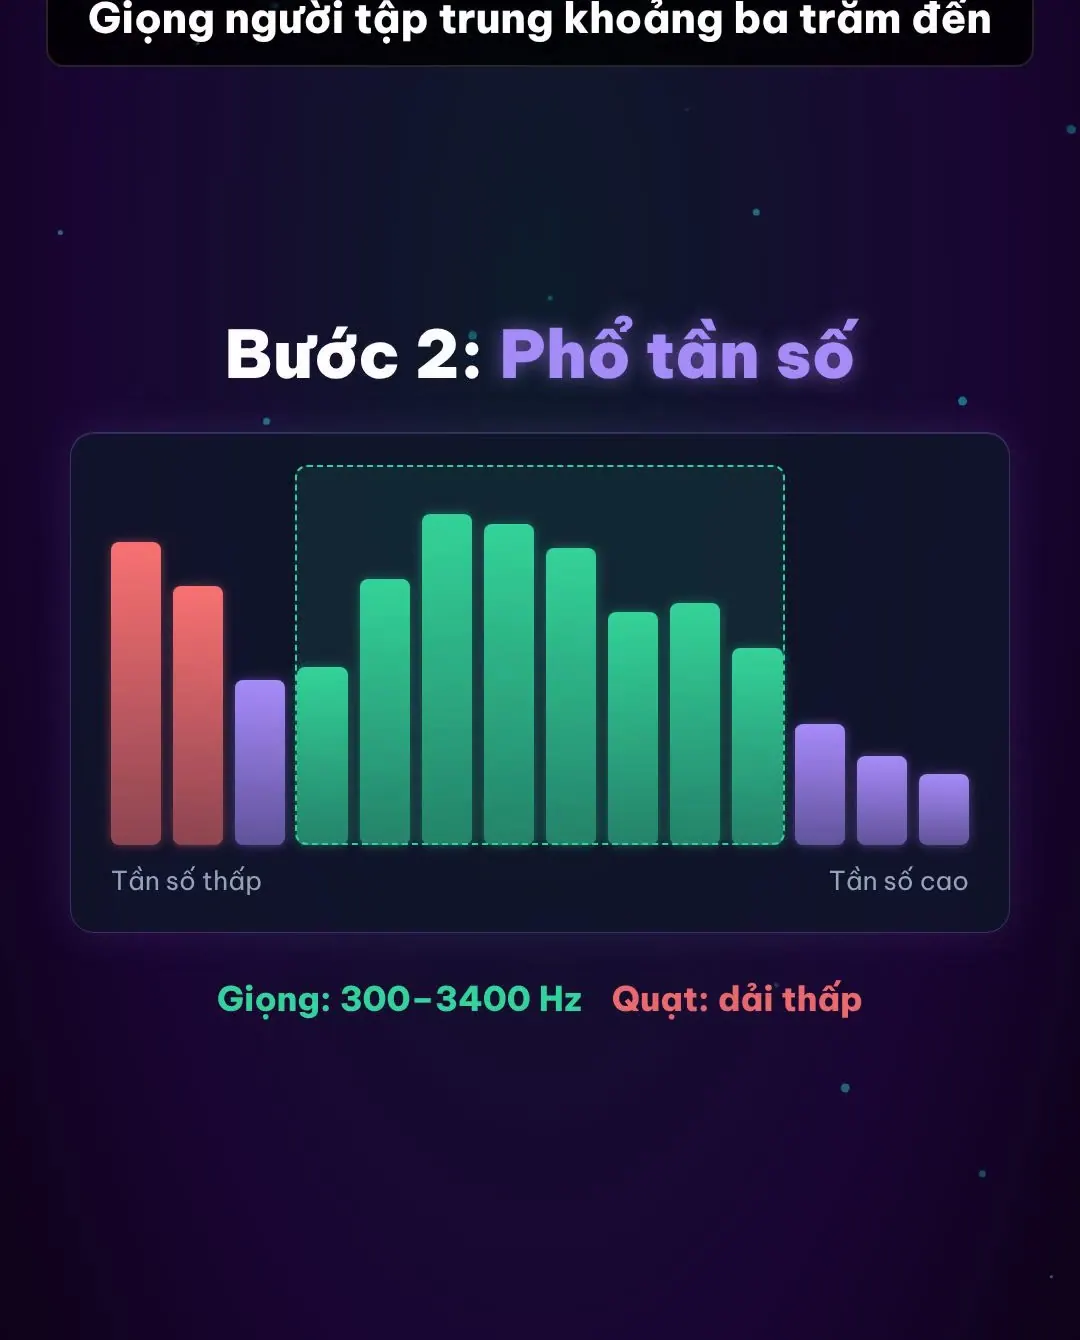
Ở dạng phổ, giọng nói và tiếng ồn bắt đầu "lộ mặt":
- Giọng người mang phần lớn thông tin để hiểu lời trong khoảng 300–3.400 Hz. Đây cũng chính là dải tần mà mạng điện thoại cố định truyền thống truyền đi.
- Tiếng quạt, điều hoà, động cơ thường dồn năng lượng ở dải thấp.
- Tiếng xì, tiếng gió trải rộng khắp các dải.
Tuy nhiên chúng vẫn chồng lấn rất nhiều. Tiếng trẻ con khóc hay tiếng người khác nói chuyện nằm ngay trong dải giọng của bạn. Vì vậy không thể chỉ dùng một bộ lọc cắt tần số cố định là xong.
Chuỗi phổ của các khung liên tiếp xếp cạnh nhau gọi là spectrogram (phổ đồ). Hầu hết thuật toán khử ồn, cả cũ lẫn mới, đều làm việc trên spectrogram thay vì trên sóng âm thô.
Cách truyền thống: trừ phổ (spectral subtraction)
Phương pháp kinh điển, được mô tả từ cuối thập niên 1970, rất trực quan:
- Khi bạn im lặng, micro chỉ thu tiếng ồn. Máy ghi lại phổ trung bình của đoạn này, gọi là "dấu vân tay" của tiếng ồn.
- Với mọi khung sau đó, máy trừ dấu vân tay này khỏi phổ thu được.
- Phần còn lại được coi là giọng nói.
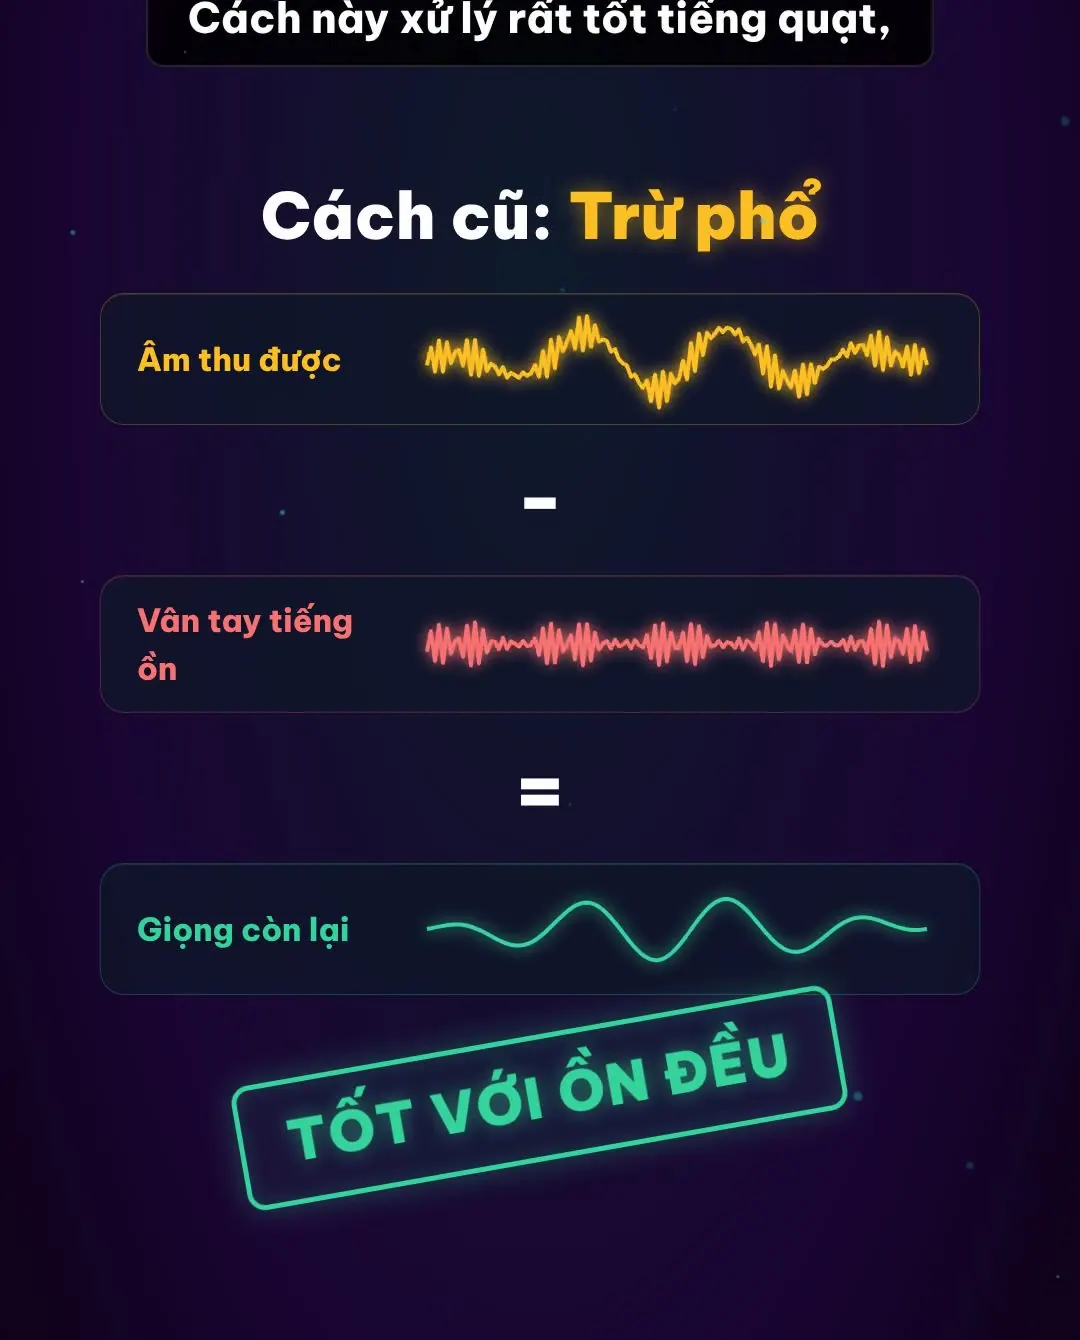
Cách này hoạt động rất tốt với tiếng ồn đều đều: quạt, điều hoà, tiếng rè nền của micro, tiếng ù của động cơ. Nó nhẹ, chạy được trên chip yếu, nên từng là lựa chọn mặc định của điện thoại và phần mềm ghi âm suốt nhiều năm. Các biến thể như bộ lọc Wiener cải tiến thêm bằng cách giảm theo tỉ lệ tín hiệu trên nhiễu thay vì trừ thẳng.
Vì sao trừ phổ bó tay với tiếng ồn bất chợt
Giả định cốt lõi của trừ phổ là: tiếng ồn không thay đổi giữa lúc im lặng và lúc nói. Giả định này sụp đổ ngay khi gặp:
- Chó sủa: xuất hiện bất chợt, không có trong vân tay đã ghi.
- Bàn phím lạch cạch: các xung ngắn, ngắt quãng liên tục.
- Trẻ con khóc: cao độ thay đổi liên tục, lại nằm đúng dải giọng nói.
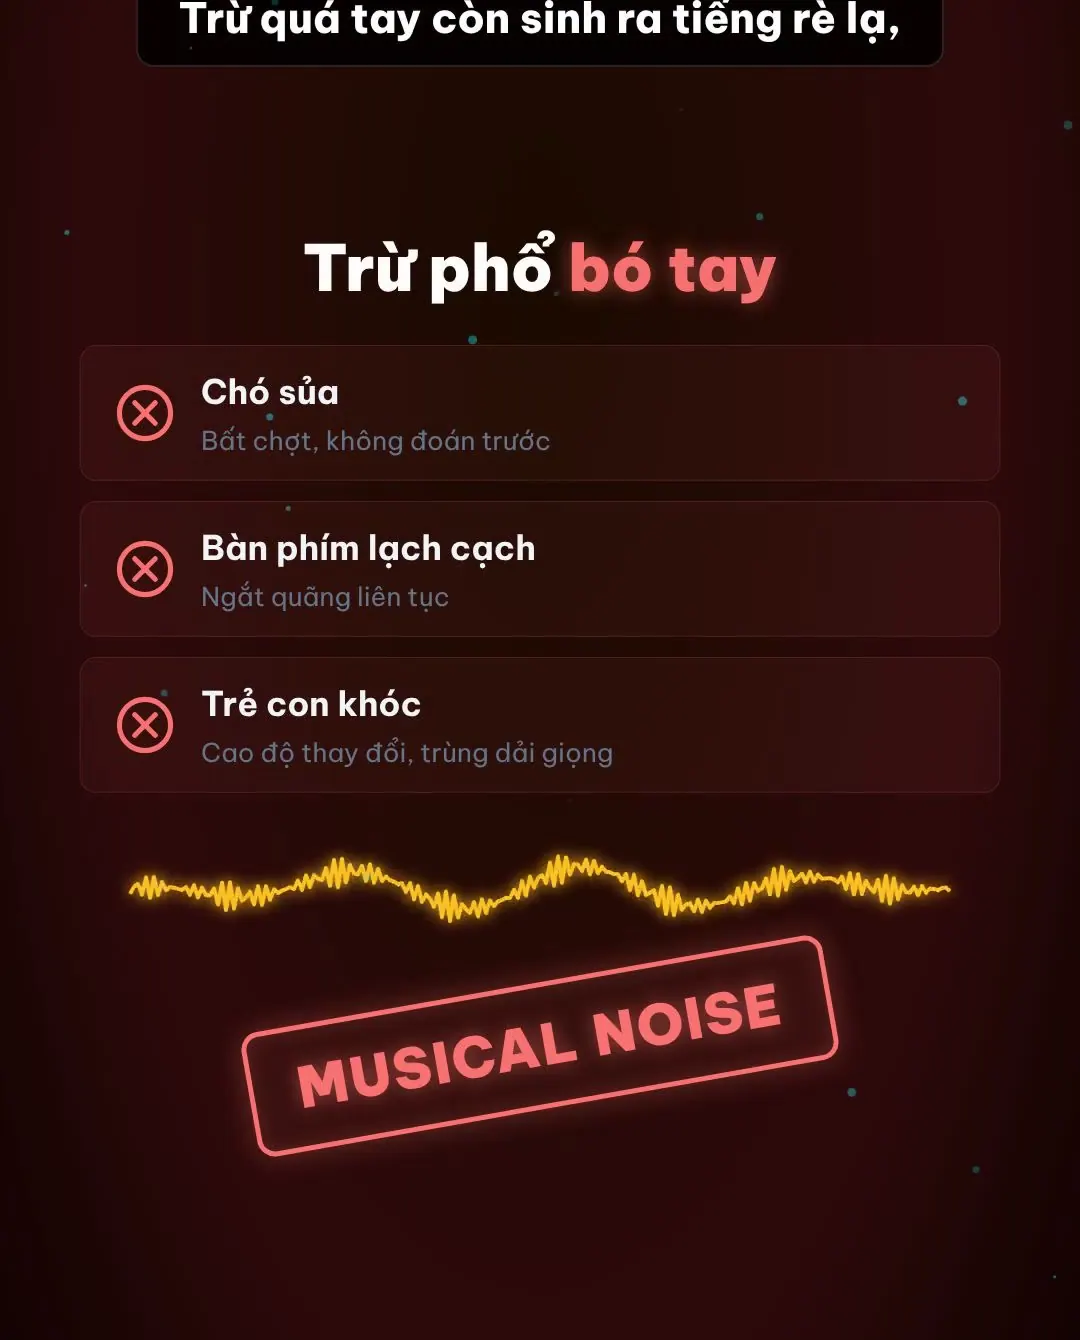
Tệ hơn, nếu trừ quá tay, những dải tần bị trừ thành giá trị âm sẽ bị cắt về 0, để lại các đỉnh năng lượng lẻ tẻ, ngẫu nhiên. Khi nghe, chúng thành tiếng lách tách, leng keng như kim loại, gọi là musical noise. Nhiều người thấy loại tạp âm nhân tạo này còn khó chịu hơn tiếng ồn ban đầu.
Cách hiện đại: mạng nơ-ron tạo mặt nạ
Thay vì dựa vào một giả định cứng, các hệ thống hiện đại học cách phân biệt giọng người và tạp âm từ dữ liệu.
Huấn luyện
Người ta chuẩn bị hàng nghìn giờ giọng nói sạch và một kho lớn các loại tiếng ồn (đường phố, quán ăn, bàn phím, chó sủa, máy hút bụi...). Hai thứ được trộn với nhau ở nhiều mức âm lượng khác nhau. Vì biết chính xác bản gốc sạch trông thế nào, mạng nơ-ron được dạy để từ bản trộn đoán ngược lại bản sạch. Sau hàng triệu ví dụ, nó nắm được những đặc điểm mà con người khó mô tả bằng quy tắc: cấu trúc hài âm của giọng nói, cách âm tiết bắt đầu và kết thúc, sự khác biệt giữa tiếng nói và tiếng va chạm.
Mặt nạ từ 0 đến 1
Khi chạy thật, với mỗi khung, mạng nơ-ron không tạo ra âm thanh mới mà xuất ra một mặt nạ (mask): một hệ số từ 0 đến 1 cho từng dải tần.
- Dải chứa chủ yếu giọng nói: hệ số gần 1, giữ nguyên.
- Dải chỉ có tiếng ồn: hệ số gần 0, gần như tắt hẳn.
- Dải lẫn cả hai: hệ số trung gian, giảm vừa phải.
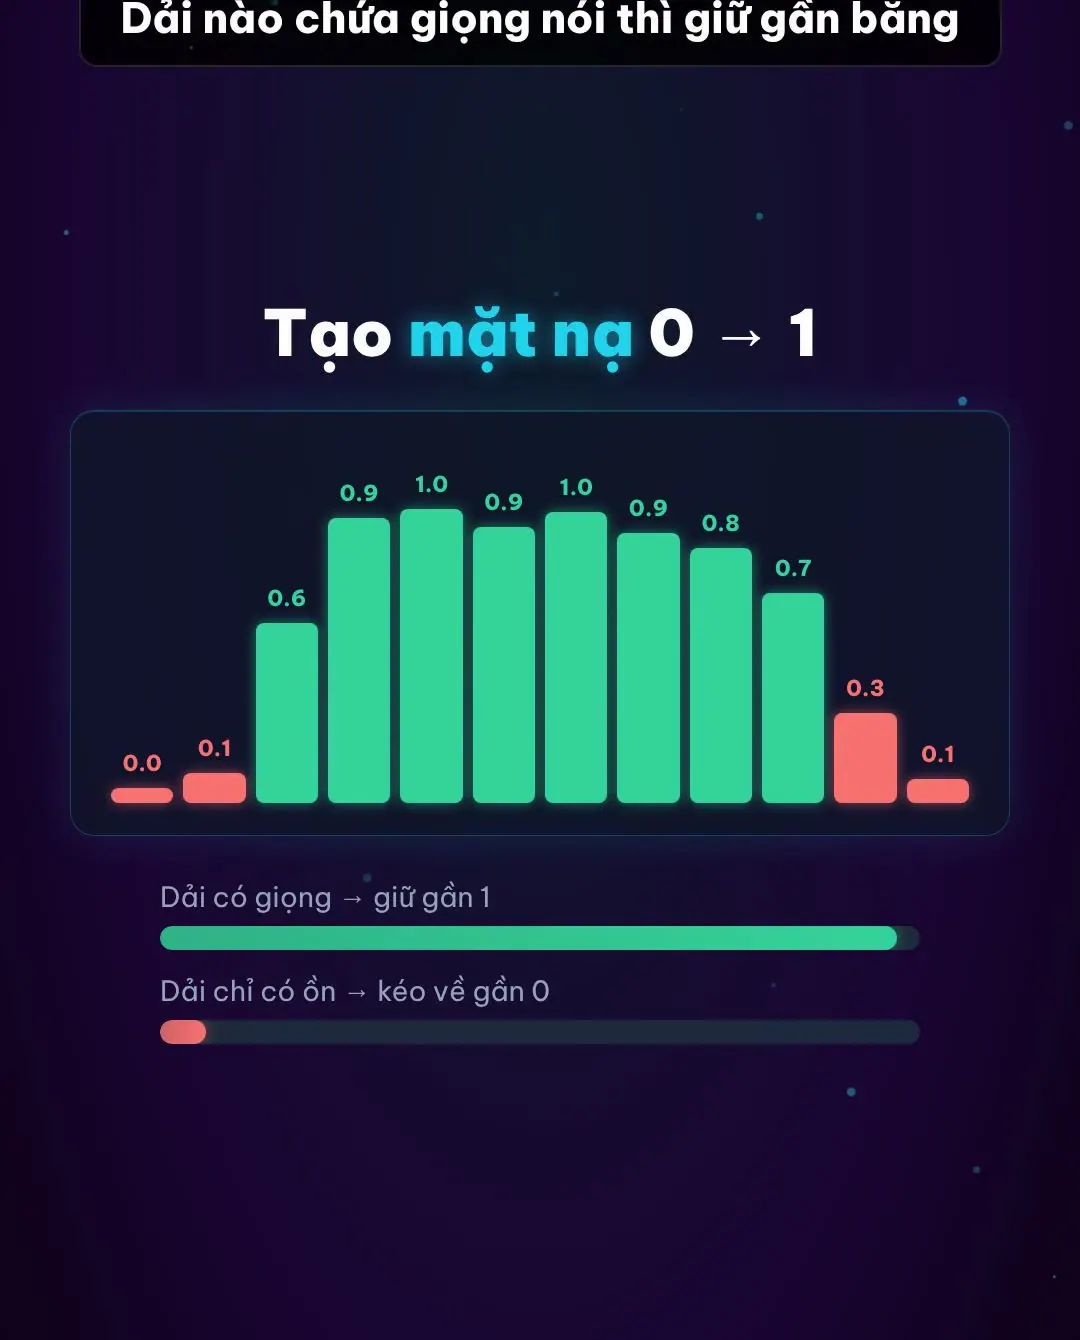
Cách làm "nhân với mặt nạ" có lợi thế lớn: kết quả luôn được dựng từ chính âm thanh gốc của bạn, nên giọng giữ được chất tự nhiên, ít bị biến dạng như khi bắt máy tự "vẽ lại" giọng nói.
Ghép lại thành giọng sạch
Máy nhân phổ gốc với mặt nạ, rồi dùng biến đổi Fourier ngược để chuyển từng khung về dạng sóng âm. Các khung chồng lấn được cộng nối mượt với nhau (kỹ thuật overlap-add) thành luồng âm thanh liên tục, sau đó được nén và gửi qua mạng. Toàn bộ quá trình chỉ thêm khoảng vài chục mili giây độ trễ, đủ nhỏ để cuộc gọi vẫn tự nhiên.
RNNoise của Jean-Marc Valin (dự án Xiph/Mozilla) là ví dụ tiêu biểu cho hướng lai: nó vẫn dùng khung và phổ như xử lý tín hiệu cổ điển, nhưng giao việc tính hệ số cho từng dải tần cho một mạng nơ-ron hồi quy rất nhỏ, đủ nhẹ để chạy thời gian thực trên CPU thông thường.
Nhiều micro cùng lúc: beamforming
AI xử lý tốt trên một micro, nhưng điện thoại và laptop còn có thêm "vũ khí" phần cứng: nhiều micro đặt ở các vị trí khác nhau.
- Micro gần miệng thu giọng to, ồn nhỏ.
- Micro ở phía sau hoặc cạnh trên thu chủ yếu tiếng ồn.
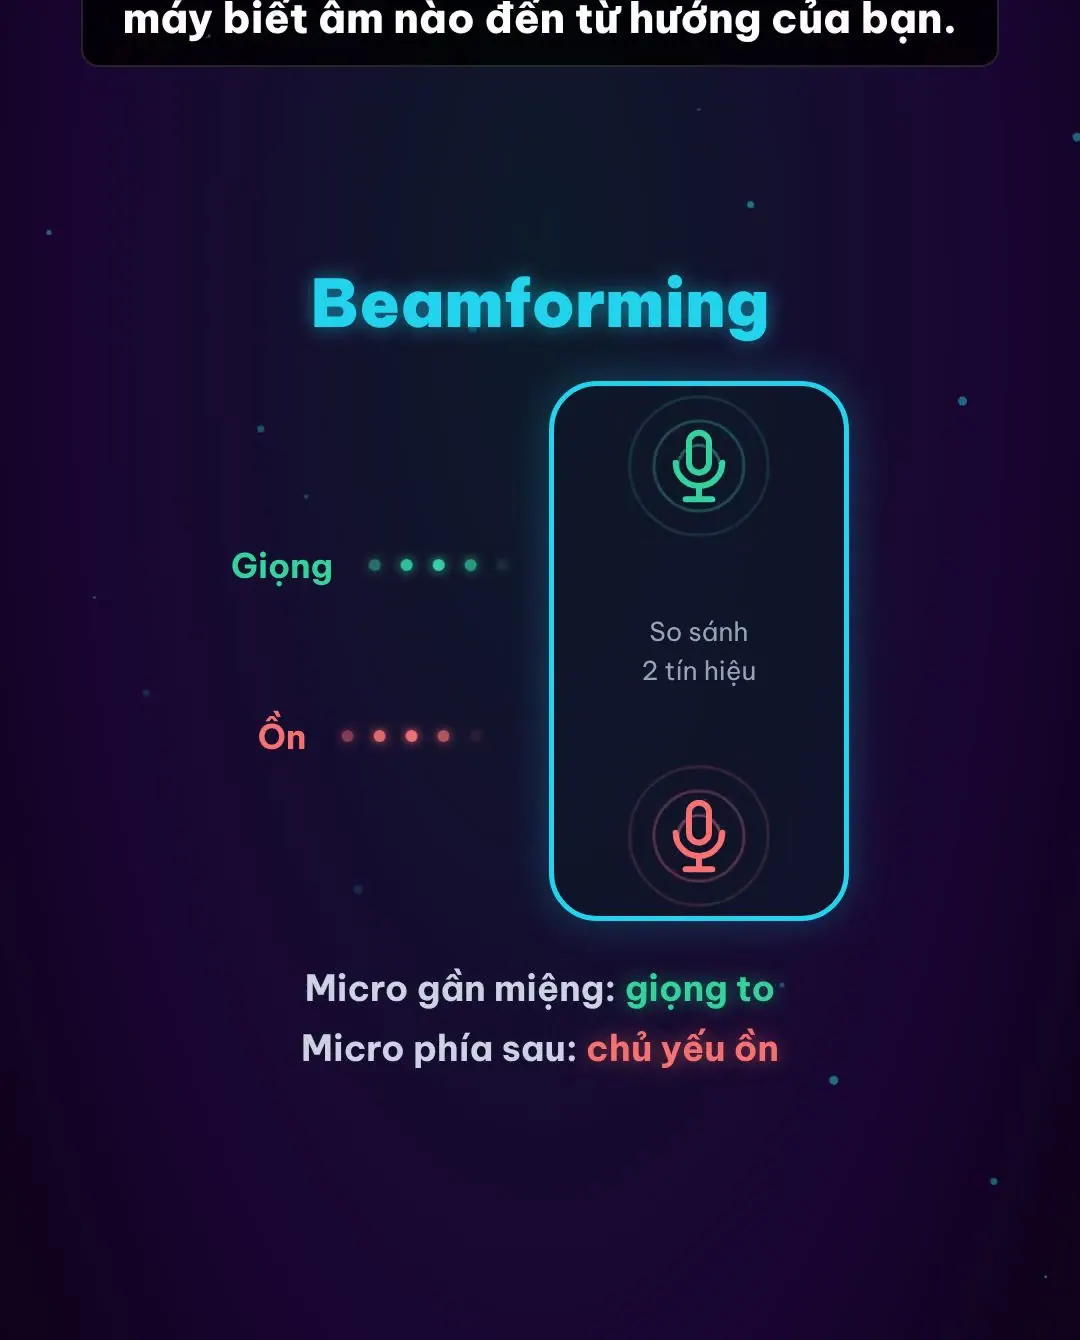
Âm thanh từ miệng bạn tới mỗi micro ở thời điểm và cường độ hơi khác nhau. Bằng cách so sánh độ lệch đó, máy xác định được âm nào đến từ hướng của bạn và tăng cường nó, đồng thời làm yếu âm đến từ các hướng khác. Kỹ thuật này gọi là beamforming, giống như tạo ra một "chùm" nghe hướng thẳng vào người nói. Kết quả beamforming sau đó thường được đưa tiếp qua bộ lọc AI để làm sạch thêm.
Thuật toán chạy ở đâu?
Noise Suppression có mặt ở nhiều tầng khác nhau, và có thể nhiều tầng cùng chạy một lúc:
| Nơi chạy | Ví dụ | Đặc điểm |
|---|---|---|
| Chip xử lý âm thanh của điện thoại, tai nghe | Chế độ đàm thoại trên smartphone, tai nghe true wireless | Tiết kiệm pin, luôn bật khi gọi |
| Card đồ hoạ | NVIDIA Broadcast (tiền thân là RTX Voice) | Mô hình lớn hơn, lọc mạnh, áp dụng cho mọi ứng dụng |
| Ứng dụng họp trực tuyến | Zoom, Google Meet, Microsoft Teams | Có tuỳ chọn mức lọc, chạy trên CPU |
Các mô hình dành cho thiết bị di động được thiết kế đủ nhẹ để chạy liên tục suốt cuộc gọi mà không làm hao pin đáng kể.
Nếu tai nghe, driver âm thanh của laptop và ứng dụng họp cùng bật khử ồn, giọng bạn có thể bị xử lý hai ba lần và nghe như đang nói trong hộp. Khi giọng bị méo, hãy thử tắt bớt một tầng, thường là tầng trong ứng dụng.
Giới hạn và mẹo dùng hiệu quả
Noise Suppression không phải phép màu. Bạn sẽ gặp các vấn đề sau:
- Tiếng ồn quá lớn so với giọng: mặt nạ phải cắt mạnh, giọng bị méo, rè hoặc mất đầu cuối âm tiết, nghe như ngắt quãng.
- Âm nhạc bị cắt: tiếng đàn, tiếng hát, tiếng vỗ tay không phải "giọng nói" theo nghĩa mô hình đã học, nên dễ bị coi là tạp âm và bị loại bỏ.
- Người khác nói gần bạn: giọng người khác cũng là giọng người, nhiều mô hình phổ thông không phân biệt được ai là chủ cuộc gọi.
Một số ứng dụng họp có chế độ âm thanh gốc dành cho nhạc công, tắt hầu hết xử lý để giữ nguyên âm sắc nhạc cụ.
Checklist trước một cuộc gọi quan trọng:
- [ ]Bật khử ồn khi ở nơi đông người, quán cà phê, văn phòng mở
- [ ]Tắt khử ồn hoặc dùng chế độ âm thanh gốc khi chơi nhạc, hát, chia sẻ âm thanh
- [ ]Đặt micro gần miệng, đúng hướng
- [ ]Chỉ bật khử ồn ở một tầng (tai nghe hoặc ứng dụng), tránh lọc chồng
- [ ]Gọi thử với một người quen để nghe giọng mình ở đầu bên kia
Mẹo đặt micro gần miệng là quan trọng nhất. Thuật toán nào cũng làm việc dựa trên tỉ lệ giữa giọng và tiếng ồn: giọng càng nổi so với nền, mặt nạ càng chính xác, giọng càng ít bị méo.
Không thuật toán nào cứu được một micro đặt sai chỗ. Đưa micro lại gần miệng là cách khử ồn rẻ nhất.
Tóm tắt nhanh
- Noise Suppression lọc âm thanh từ micro để người nghe không phải chịu tiếng ồn, khác với ANC giúp chính bạn không nghe tiếng ồn.
- Âm thanh được cắt thành khung 10–20 ms, biến đổi Fourier thành phổ để phân tích từng dải tần.
- Trừ phổ truyền thống tốt với ồn đều nhưng thất bại với ồn bất chợt và dễ sinh musical noise.
- Mạng nơ-ron tạo mặt nạ 0–1 cho từng dải tần, giữ giọng nói và tắt tạp âm; beamforming với nhiều micro giúp lọc thêm theo hướng.
- Tắt khử ồn khi chia sẻ âm nhạc và luôn đặt micro gần miệng.
Câu hỏi thường gặp
Noise Suppression có làm giọng tôi nghe khác đi không?
Có thể, nhất là khi môi trường quá ồn hoặc bật nhiều tầng lọc cùng lúc. Ở điều kiện bình thường, các mô hình dạng mặt nạ giữ giọng khá tự nhiên vì chúng chỉ giảm bớt thành phần ồn từ âm thanh gốc.
Vì sao chơi đàn qua Zoom hay Meet thì tiếng đàn bị mất?
Mô hình được huấn luyện để giữ giọng nói, nên tiếng nhạc cụ bị coi là tạp âm. Hãy hạ mức khử ồn hoặc bật chế độ âm thanh gốc của ứng dụng khi chơi nhạc.
Tai nghe có ANC thì có cần Noise Suppression không?
ANC chỉ giúp bạn nghe yên tĩnh, không làm sạch giọng bạn gửi đi. Muốn người bên kia nghe rõ, bạn vẫn cần Noise Suppression ở micro, tai nghe hoặc trong ứng dụng.
Khử ồn có làm cuộc gọi bị trễ không?
Có thêm một chút, thường chỉ vài chục mili giây do phải chờ đủ khung và xử lý. Mức này đủ nhỏ để bạn không cảm nhận được trong hội thoại bình thường.