Bạn gọi video bằng loa ngoài, giọng người bên kia phát ra loa rồi lọt ngược vào chính micro của bạn chỉ vài mili giây sau. Theo lẽ thường, họ phải nghe lại giọng mình vọng về. Vậy mà cuộc gọi vẫn sạch sẽ. Thứ làm được điều đó là Echo Cancellation (khử tiếng vọng, thường viết tắt là AEC), một trong những thuật toán xử lý tín hiệu chạy nhiều nhất thế giới mà gần như không ai để ý.
Bài này đi từ ý tưởng đơn giản nhất tới những phần khó: bộ lọc thích nghi, thuật toán NLMS, chuyện hai người nói cùng lúc, độ trễ trên điện thoại và vai trò của AI.
Tiếng vọng sinh ra như thế nào
Hãy xét một cuộc gọi giữa A và B. Giọng của B truyền qua mạng, tới máy của A và phát ra loa. Âm thanh đó lan trong phòng, chạm vào micro của A và bị thu lại cùng giọng A. Máy A gửi toàn bộ tín hiệu micro về cho B. Kết quả: B nghe thấy giọng mình quay về.
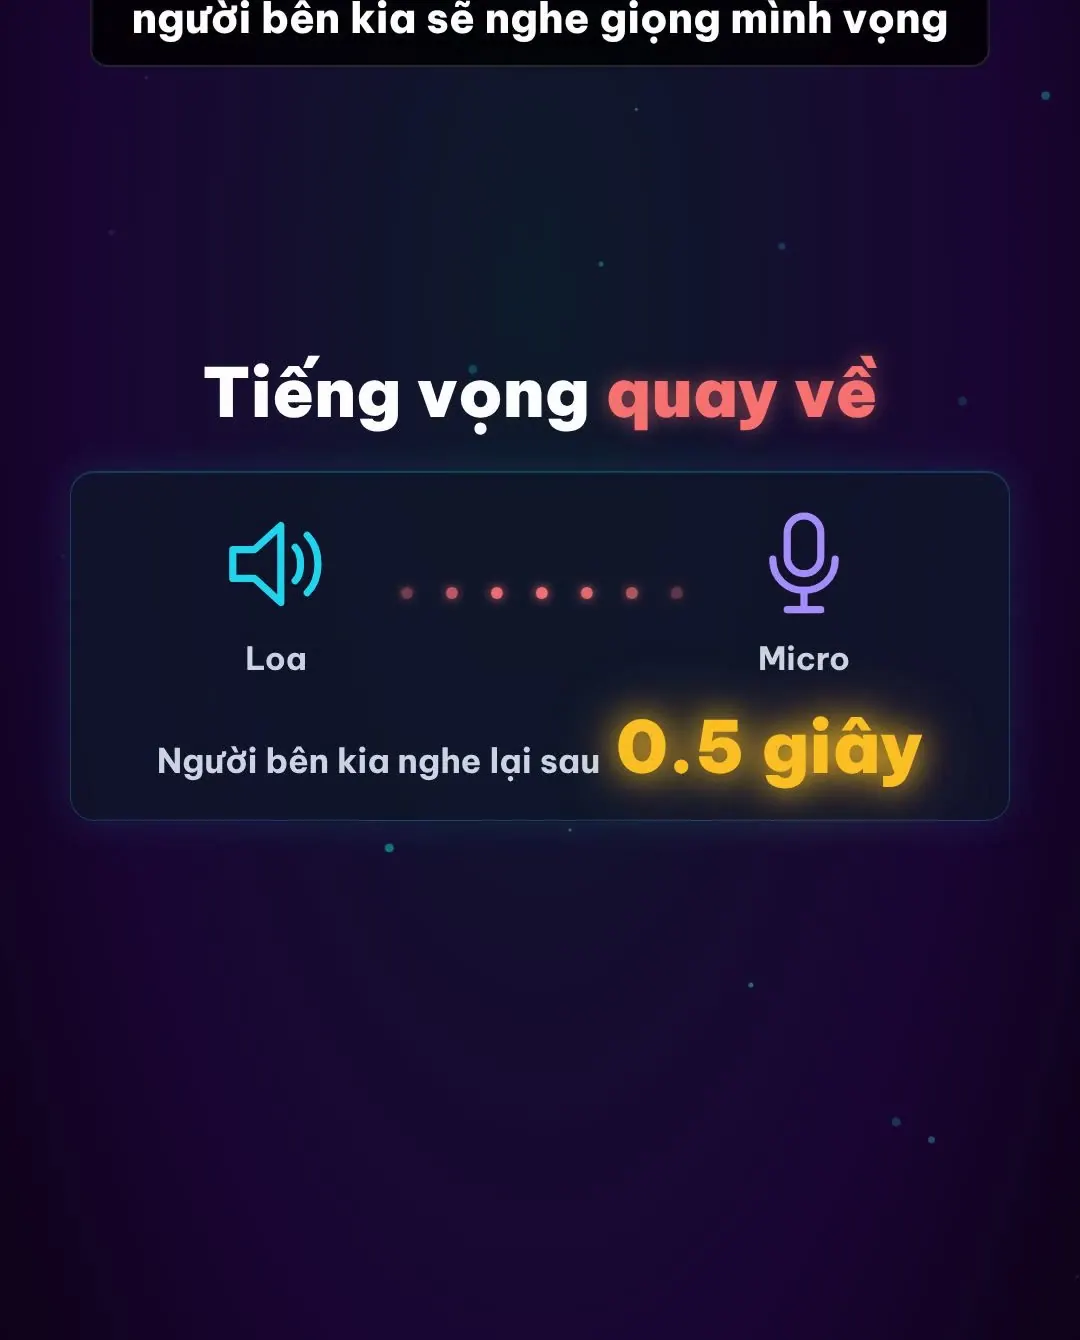
Bản thân quãng đường loa tới micro rất ngắn. Âm thanh đi khoảng 343 m/s, tức chừng 3 mili giây cho mỗi mét. Cái làm tiếng vọng khó chịu là tổng độ trễ của cả vòng: mã hoá âm thanh, bộ đệm chống giật, đường truyền mạng đi và về. Cộng lại, tiếng vọng có thể về tới tai người nói sau vài trăm mili giây. Ở mức trễ đó, não không còn coi nó là một phần giọng mình mà nghe thành một bản sao lạc lõng, khiến người nói bị khựng lại, nói lắp hoặc mất mạch.
Tệ hơn, nếu cả hai đầu đều dùng loa ngoài và không có gì ngăn lại, âm thanh có thể chạy vòng tròn loa sang micro, qua mạng, sang loa bên kia rồi quay lại. Khi độ khuếch đại của vòng này vượt quá 1, ta nghe tiếng rú rít, giống hiện tượng hú micro trên sân khấu.
Hai loại tiếng vọng: đường truyền và âm học
Thực tế có hai nguồn tiếng vọng khác hẳn nhau:
| Tiếng vọng đường truyền (line echo) | Tiếng vọng âm học (acoustic echo) | |
|---|---|---|
| Nơi sinh ra | Mạch chuyển đổi 2 dây sang 4 dây (hybrid) trong mạng điện thoại cũ | Không gian giữa loa và micro trên cùng thiết bị |
| Đặc điểm | Đường vọng ngắn, ít thay đổi | Đường vọng dài, đổi liên tục khi người hoặc đồ vật di chuyển |
| Ví dụ | Gọi qua tổng đài, điện thoại bàn | Điện thoại loa ngoài, laptop, loa thông minh, ô tô |
| Tiêu chuẩn tham khảo | ITU-T G.168 cho bộ khử vọng đường truyền | Phụ thuộc thiết kế từng hãng |
Tiếng vọng đường truyền được giải quyết từ lâu vì "căn phòng" của nó chỉ là một mạch điện, khá ổn định. Tiếng vọng âm học khó hơn nhiều, vì kênh truyền là cả một không gian vật lý luôn biến đổi. Phần còn lại của bài tập trung vào loại thứ hai.
Ý tưởng cốt lõi: đoán trước rồi trừ đi
Điểm mấu chốt là máy biết chính xác tín hiệu nó vừa đưa ra loa, gọi là tín hiệu tham chiếu (far-end signal). Tiếng vọng ở micro chẳng qua là tín hiệu tham chiếu đó sau khi bị loa, căn phòng và micro "biến dạng".
Vậy nếu máy mô phỏng được sự biến dạng ấy, nó có thể tự tạo ra một bản tiếng vọng dự đoán, rồi lấy tín hiệu micro trừ đi:
Tín hiệu gửi đi = Tín hiệu micro − Tiếng vọng dự đoán
Nếu dự đoán khớp hoàn hảo, phần còn lại chỉ là giọng của bạn cùng tiếng ồn xung quanh.
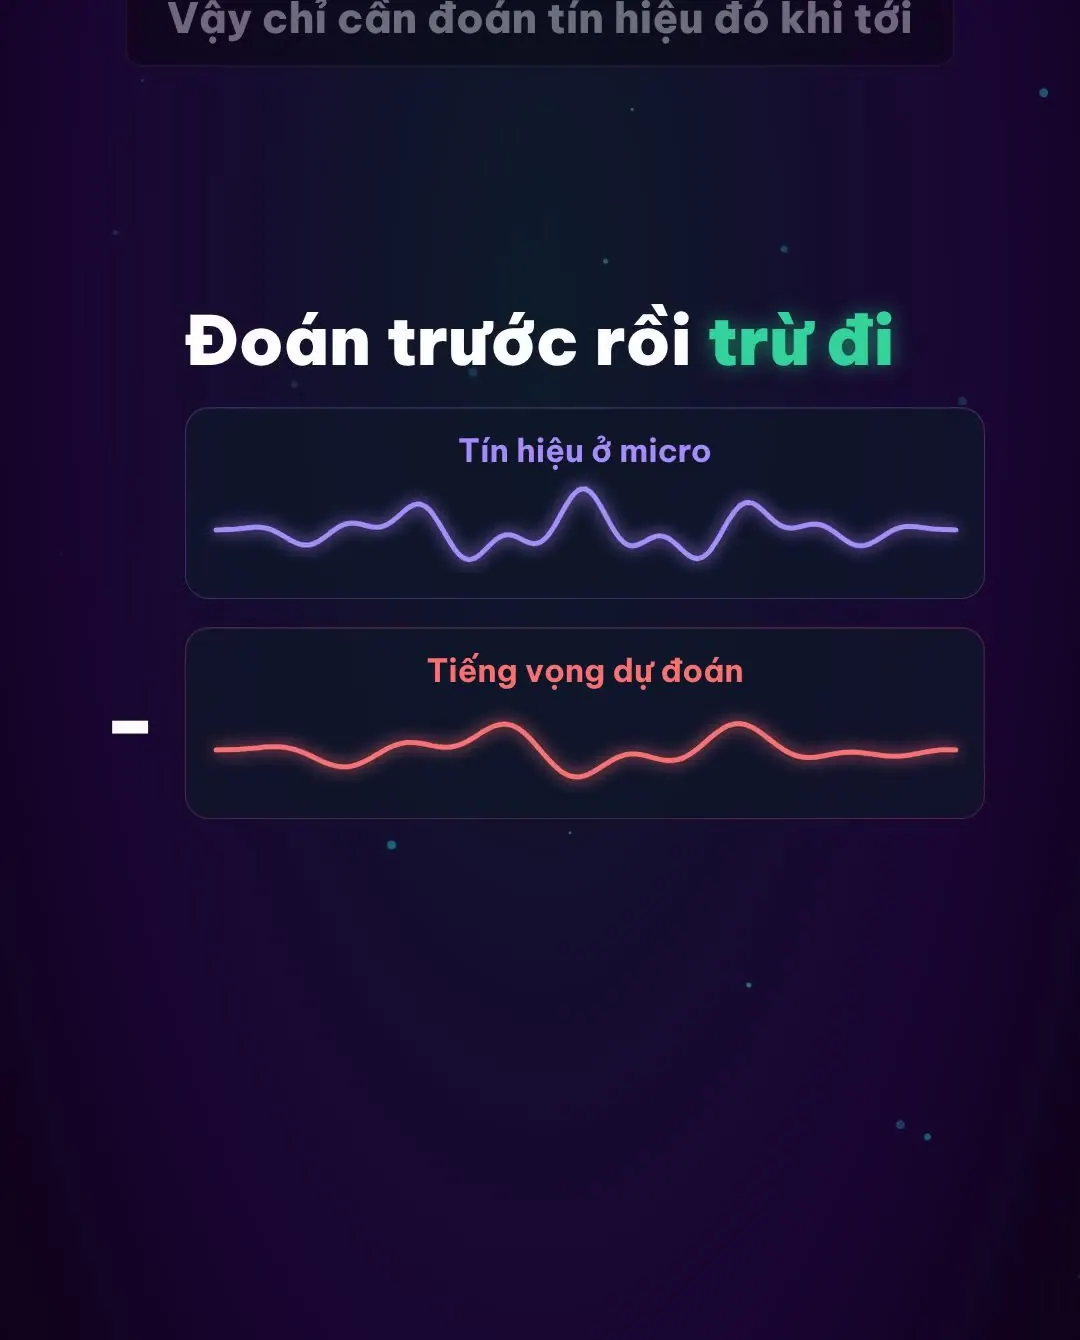
Nghe thì đơn giản, nhưng cái khó nằm ở chữ "mô phỏng". Âm thanh không đi một đường thẳng từ loa tới micro.
Đáp ứng xung: dấu vân tay của căn phòng
Khi loa phát ra âm thanh, một phần đi thẳng tới micro, phần khác dội vào tường, trần, mặt bàn, màn hình, cơ thể bạn rồi mới tới nơi. Mỗi đường đi tạo ra một bản sao của âm thanh gốc, trễ hơn và yếu hơn. Trong một căn phòng bình thường có hàng trăm bản sao như vậy chồng lên nhau.
Tập hợp tất cả các đường đi đó được mô tả bằng đáp ứng xung (impulse response): nếu loa phát ra một tiếng "tách" cực ngắn, micro sẽ thu được một vạch lớn đầu tiên (đường thẳng), theo sau là một đuôi dài những vạch nhỏ dần (tiếng dội).
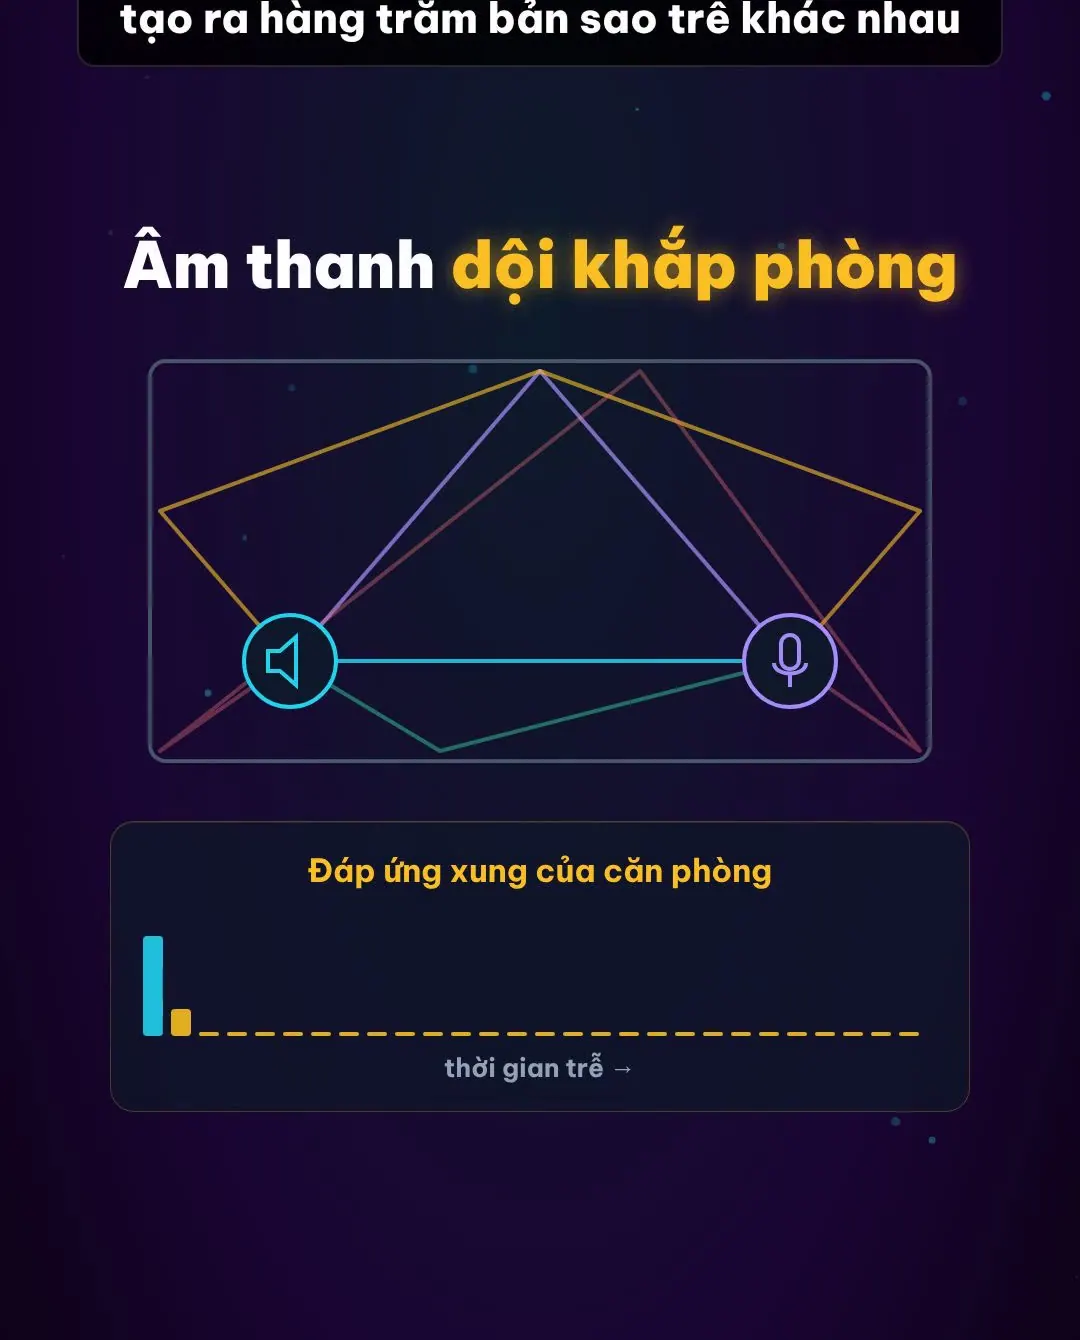
Về mặt toán học, tiếng vọng ở micro bằng tín hiệu loa tích chập với đáp ứng xung này. Nếu biết đáp ứng xung, ta tính được tiếng vọng. Vấn đề là không ai đo sẵn đáp ứng xung cho từng căn phòng, và nó thay đổi mỗi khi bạn nghiêng điện thoại hay có người đi qua.
Bộ lọc thích nghi và thuật toán NLMS
Giải pháp là để máy tự học đáp ứng xung trong lúc gọi, bằng một bộ lọc thích nghi (adaptive filter). Bộ lọc này là một dãy hệ số, mỗi hệ số ứng với độ mạnh của tiếng dội tại một khoảng trễ. Số hệ số quyết định bộ lọc "nhìn" được tiếng vọng dài bao lâu. Ví dụ, ở tần số lấy mẫu 16 kHz, muốn bao phủ 100 ms tiếng dội thì cần 1.600 hệ số. Vì vậy các bộ khử vọng thường có từ vài trăm tới vài nghìn hệ số.
Thuật toán học phổ biến nhất là NLMS (Normalized Least Mean Squares). Với mỗi mẫu âm thanh, nó làm ba bước:
- Dự đoán tiếng vọng bằng cách nhân các mẫu loa gần đây với bộ hệ số hiện tại rồi cộng lại.
- So với tín hiệu micro thật, lấy phần chênh lệch gọi là sai số e.
- Chỉnh hệ số theo hướng làm sai số nhỏ đi.
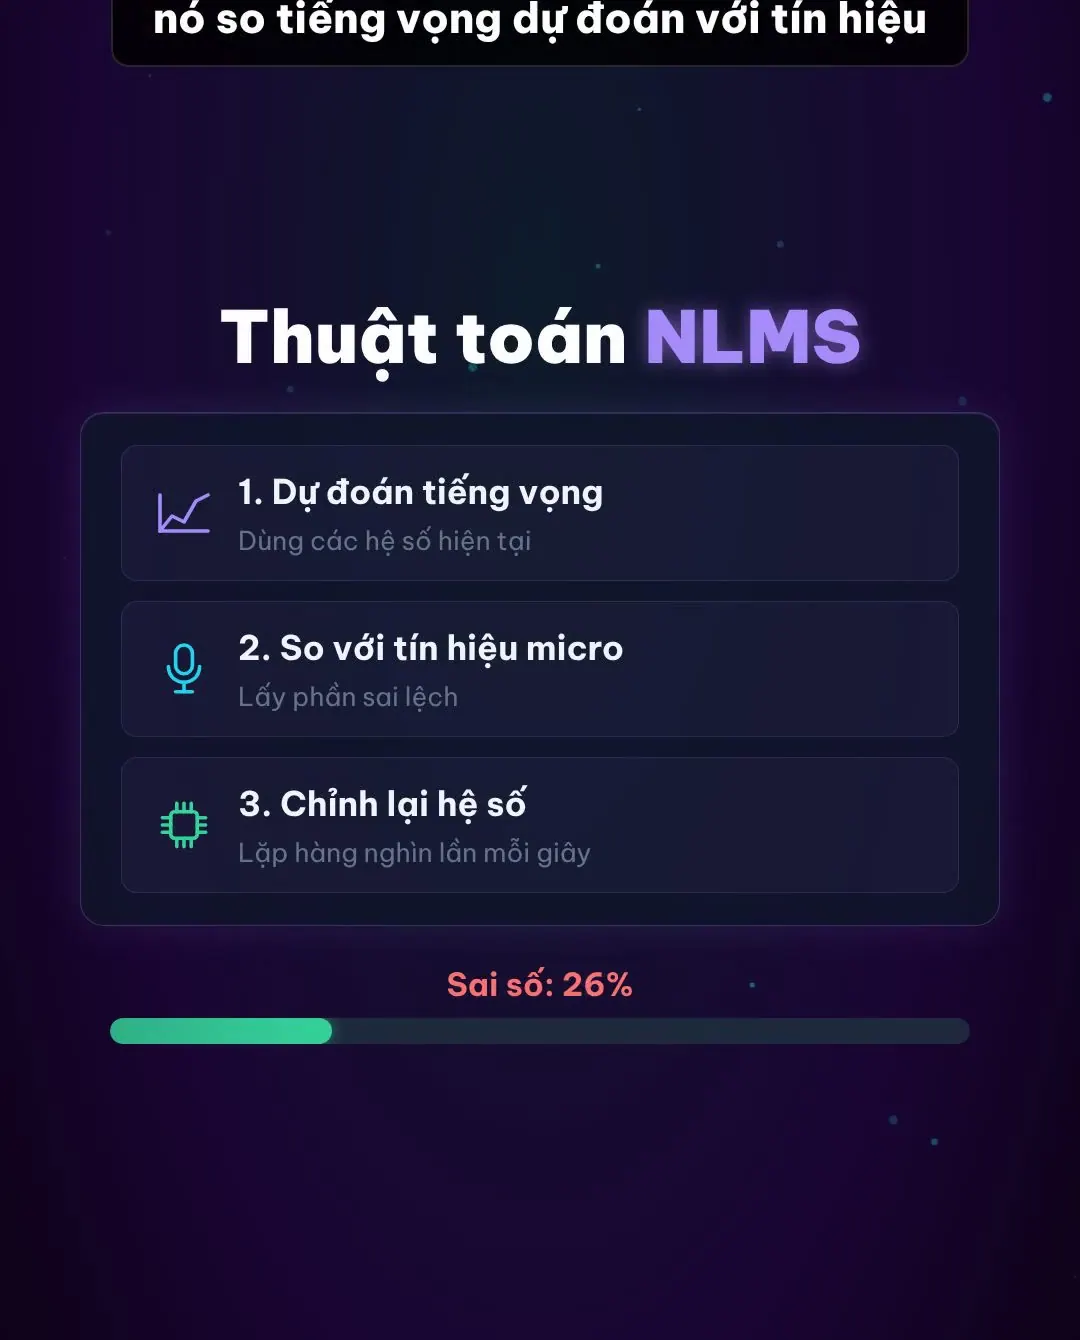
Công thức cập nhật có dạng:
w(n+1) = w(n) + mu * e(n) * x(n) / (||x(n)||^2 + delta)
Trong đó w là vector hệ số, x là các mẫu loa gần nhất, e là sai số, mu là bước học. Chữ "Normalized" nằm ở phép chia cho năng lượng tín hiệu loa: nhờ vậy tốc độ học không phụ thuộc loa đang to hay nhỏ. delta là một số nhỏ để tránh chia cho 0 khi loa im lặng.
Chọn mu là bài toán đánh đổi: lớn thì học nhanh nhưng dao động, nhỏ thì ổn định nhưng chậm thích ứng khi phòng thay đổi.
Với hàng nghìn hệ số và 16.000 mẫu mỗi giây, NLMS thuần trong miền thời gian khá nặng. Nhiều hệ thống hiện đại, ví dụ bộ khử vọng AEC3 trong WebRTC (thư viện âm thanh mà trình duyệt Chrome dùng cho gọi video), chia tín hiệu thành từng khối và xử lý trong miền tần số để giảm khối lượng tính toán, đồng thời học nhanh hơn.
Bộ lọc tốt giảm được bao nhiêu tiếng vọng
Khi bộ lọc đã hội tụ, tín hiệu sau khi trừ chỉ còn một lượng tiếng vọng rất nhỏ. Chỉ số đo hiệu quả này gọi là ERLE (Echo Return Loss Enhancement), tính bằng decibel. Một bộ lọc tuyến tính tốt thường đạt khoảng 30 đến 40 dB.
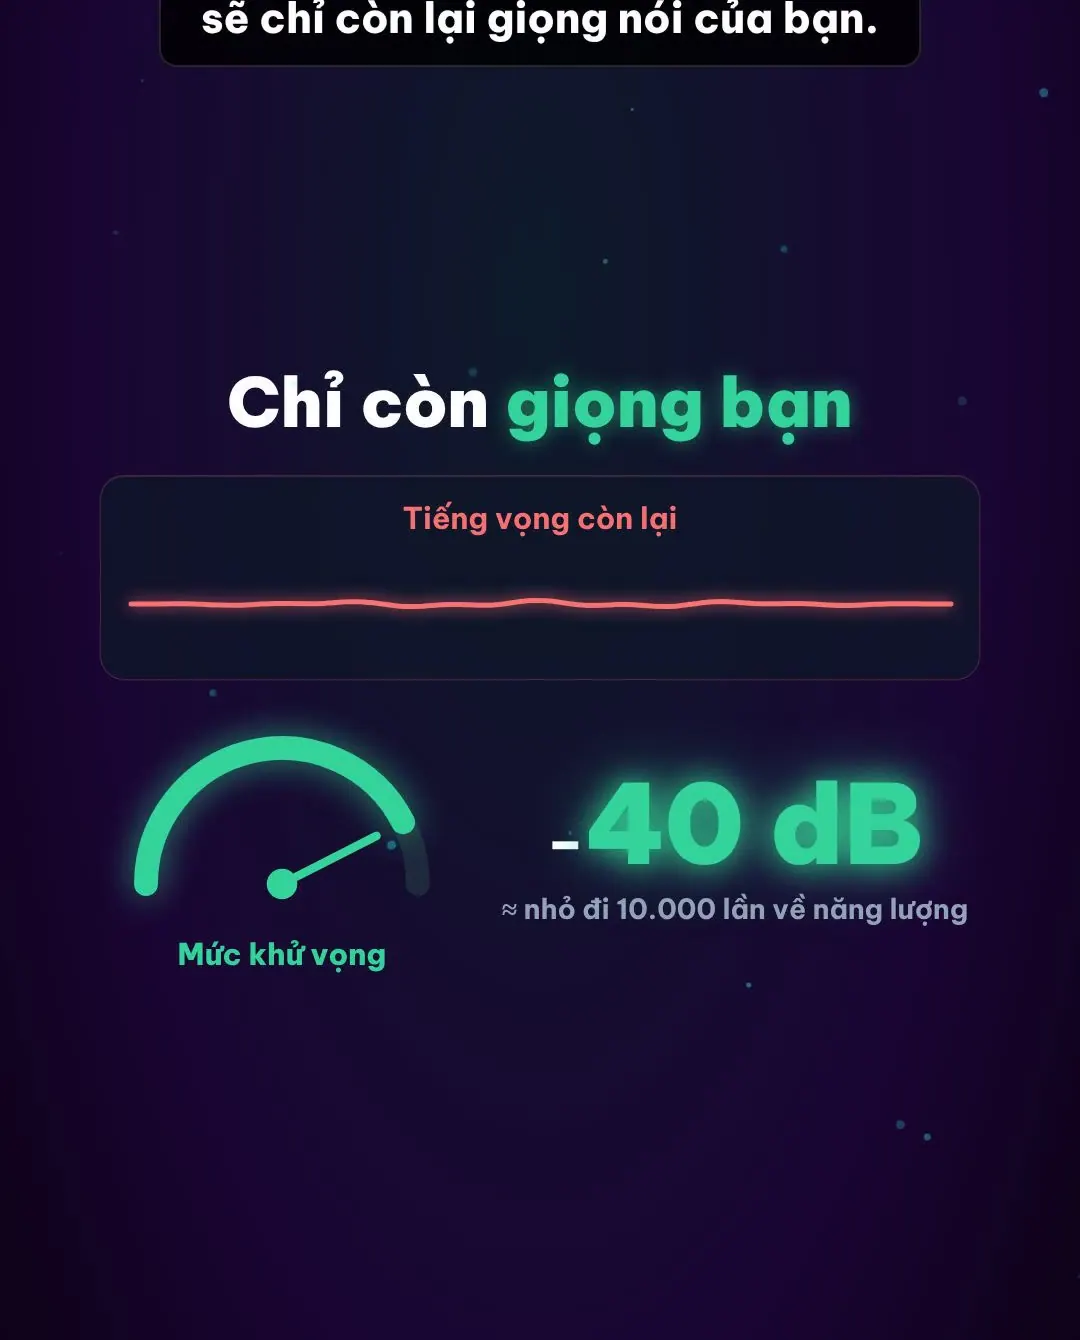
Decibel là thang logarit: giảm 30 dB nghĩa là năng lượng tiếng vọng còn khoảng 1/1.000, giảm 40 dB là còn 1/10.000. Nghe thì ấn tượng, nhưng tai người nhạy tới mức phần còn sót đôi khi vẫn nghe ra được, nhất là khi loa phát to. Đó là lý do cần thêm các tầng xử lý phía sau.
Phần khó nhất: double talk
Bộ lọc học bằng cách coi mọi thứ còn lại sau phép trừ là "sai số do mình đoán chưa đúng". Điều này chỉ đúng khi chỉ có người bên kia nói. Khi bạn cũng lên tiếng, giọng bạn xuất hiện trong micro và bị coi nhầm là sai số. Bộ lọc sẽ hăng hái chỉnh hệ số để "khử" luôn giọng bạn, làm hỏng mô hình đã học. Tình huống này gọi là double talk.
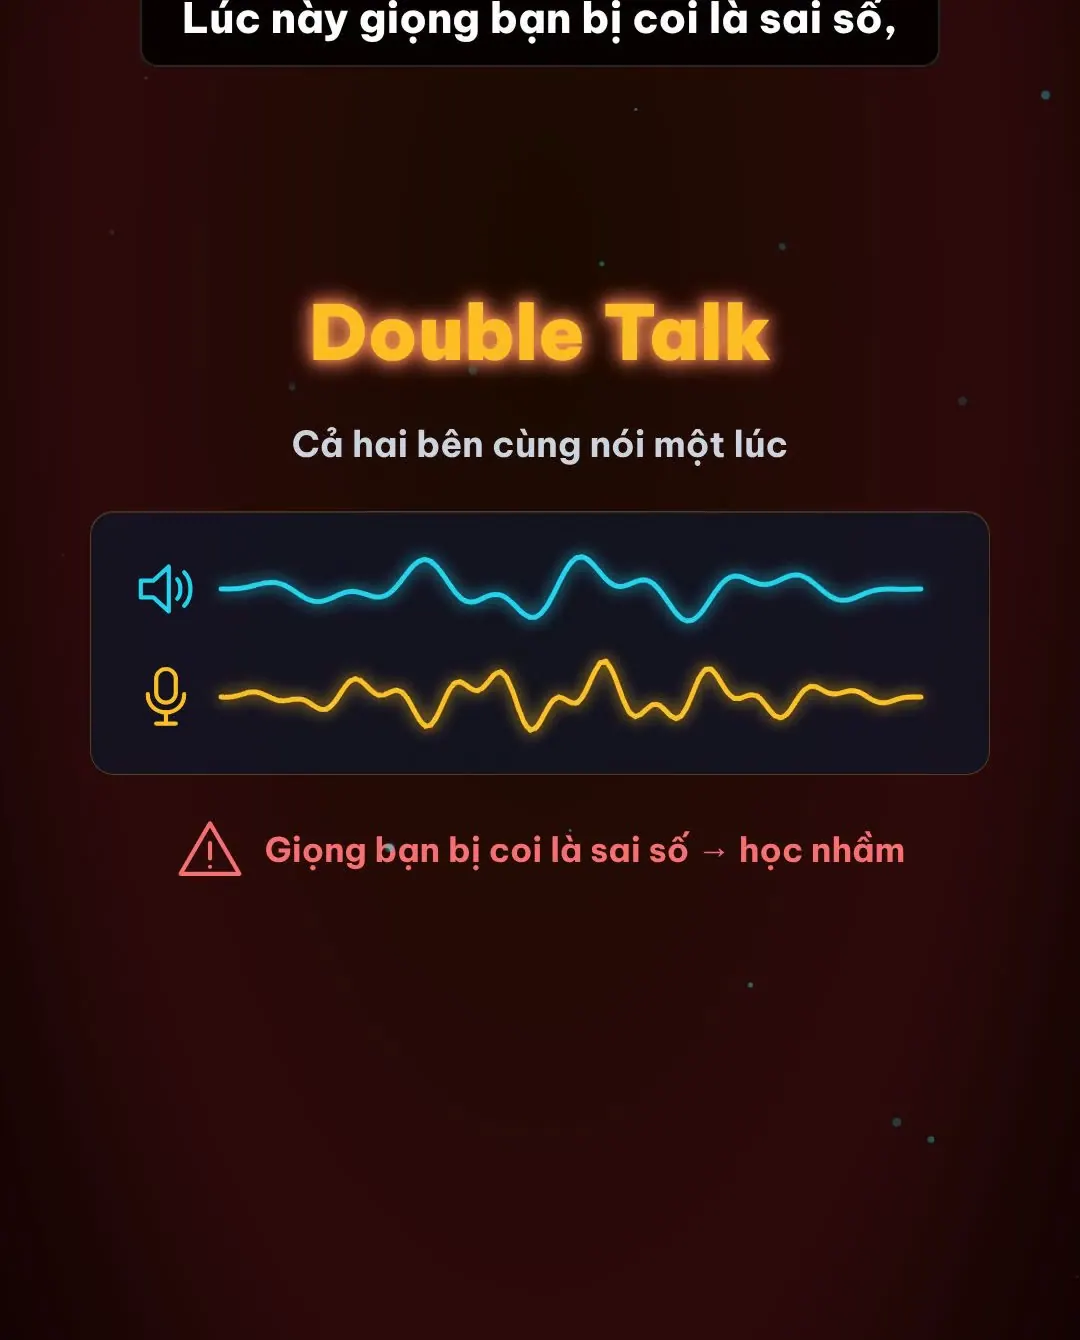
Cách xử lý kinh điển là thêm một bộ phát hiện double talk (double-talk detector). Khi phát hiện cả hai bên cùng nói, máy tạm đóng băng việc học nhưng vẫn tiếp tục trừ tiếng vọng bằng hệ số cũ. Bộ phát hiện đơn giản nhất (thuật toán Geigel) so biên độ micro với biên độ loa gần đây: nếu micro to bất thường so với những gì loa có thể tạo ra, chắc chắn có người ở gần đang nói.
Khó ở chỗ phát hiện phải vừa nhanh vừa chính xác. Phát hiện chậm vài chục mili giây là bộ lọc đã kịp học sai. Phát hiện nhầm quá nhiều thì bộ lọc ít được học, theo không kịp khi phòng thay đổi.
Giọng bạn bị nhỏ đi hoặc mất chữ đầu câu khi chen ngang người khác, hoặc người bên kia than nghe tiếng vọng mỗi lần hai bên cùng nói. Đó là lúc double talk đang làm khó bộ lọc.
Tầng hậu xử lý và bài toán độ trễ
Khử phần phi tuyến còn sót
Bộ lọc thích nghi giả định căn phòng là hệ tuyến tính: âm vào to gấp đôi thì vọng ra to gấp đôi. Thực tế, loa điện thoại nhỏ bị méo khi phát lớn, vỏ máy rung, bộ nén âm lượng tự động thay đổi tín hiệu. Những thành phần phi tuyến này bộ lọc không mô phỏng được.
Vì vậy sau bộ lọc luôn có một tầng xử lý phi tuyến (NLP, residual echo suppression). Nó ước lượng ở từng dải tần còn bao nhiêu tiếng vọng và hạ âm lượng dải đó xuống. Làm nhẹ tay thì còn vọng, làm quá tay thì giọng bạn bị bóp nhỏ, rè hoặc ngắt quãng. Hiện tượng cuộc gọi loa ngoài chỉ một bên nói được tại một thời điểm (half-duplex) thường là dấu hiệu tầng này đang làm mạnh tay.
Căn chỉnh thời gian
Trên điện thoại và máy tính, âm thanh đi qua nhiều tầng phần mềm và driver trước khi ra loa, rồi lại qua nhiều tầng nữa khi vào từ micro. Độ lệch giữa lúc phần mềm "gửi" tín hiệu loa và lúc tiếng vọng thực sự xuất hiện trong luồng micro có thể lên tới hàng trăm mili giây, và không cố định.
Nếu bộ lọc chỉ dài 100 ms mà tiếng vọng tới trễ 200 ms, nó sẽ không bao giờ thấy tiếng vọng. Do đó các bộ khử vọng hiện đại có thêm khối ước lượng độ trễ: tìm điểm tương quan cao nhất giữa tín hiệu loa và micro, rồi dịch tín hiệu tham chiếu cho khớp trước khi đưa vào bộ lọc.
AI vào cuộc và những nơi Echo Cancellation đang chạy
Những năm gần đây, mạng nơ-ron được đưa vào chuỗi xử lý, thường để thay hoặc hỗ trợ tầng hậu xử lý. Thay vì dựa vào quy tắc thủ công, mô hình được huấn luyện trên lượng lớn dữ liệu để học cách tách giọng người gần khỏi tiếng vọng và tiếng ồn, kể cả khi hai bên nói chồng lên nhau. Microsoft từng tổ chức cuộc thi AEC Challenge tại hội nghị ICASSP để thúc đẩy hướng nghiên cứu này. Các nền tảng họp trực tuyến như Zoom, Google Meet hay Microsoft Teams đều công bố có xử lý âm thanh bằng AI, dù chi tiết thuật toán không được công khai.
Cách phổ biến hiện nay là lai: bộ lọc tuyến tính cổ điển vẫn làm phần nặng vì nó rẻ, ổn định và dễ giải thích, còn mạng nơ-ron dọn phần còn sót mà phương pháp truyền thống làm kém.
Echo Cancellation gần như có mặt ở mọi thiết bị vừa phát vừa thu âm:
- Điện thoại khi bật loa ngoài hoặc gọi video.
- Laptop khi họp online không đeo tai nghe.
- Thiết bị phòng họp: thanh loa camera, loa hội nghị đặt bàn.
- Hệ thống rảnh tay trên ô tô: loa và micro cùng nằm trong khoang xe nhỏ, nhiều mặt phản xạ.
- Loa thông minh: nhờ khử chính âm nhạc mình đang phát, loa vẫn nghe được câu lệnh gọi tên trợ lý dù đang mở nhạc khá to.
Mẹo để cuộc gọi không bị vọng
Bộ khử vọng giỏi tới đâu cũng làm việc tốt hơn khi bạn giúp nó một chút:
- [ ]Đeo tai nghe khi họp online: âm thanh không ra không khí nên tiếng vọng âm học gần như biến mất từ gốc.
- [ ]Giảm âm lượng loa vừa đủ nghe: loa càng to càng dễ méo, sinh phần phi tuyến mà bộ lọc không khử được.
- [ ]Không để hai thiết bị cùng vào một cuộc họp trong cùng phòng, ví dụ laptop và điện thoại: thiết bị này không biết tín hiệu loa của thiết bị kia nên không thể khử.
- [ ]Đừng che micro hoặc đặt điện thoại úp sát mặt bàn khi gọi loa ngoài.
- [ ]Phòng nhiều kính, tường trống thì thêm rèm, thảm để giảm tiếng dội.
Nếu người khác than nghe tiếng vọng thì vấn đề thường nằm ở máy của người khác đó hoặc của một người thứ ba trong cuộc họp, không phải máy của người bị nghe vọng. Tiếng vọng bạn nghe thấy là do micro bên kia thu lại loa bên kia.
Tóm tắt nhanh
- Tiếng vọng xảy ra khi âm thanh từ loa lọt ngược vào micro và bị gửi về người nói, cộng thêm độ trễ mạng nên rất khó chịu.
- Ý tưởng cốt lõi: máy biết tín hiệu nó phát ra loa, nên mô phỏng tiếng vọng rồi trừ khỏi tín hiệu micro.
- Bộ lọc thích nghi, thường dùng NLMS, tự học đáp ứng xung của căn phòng và có thể giảm khoảng 30 đến 40 dB tiếng vọng.
- Phần khó là double talk, méo phi tuyến và độ trễ thay đổi; cần bộ phát hiện double talk, tầng hậu xử lý và khối căn chỉnh thời gian.
- AI hiện được dùng để dọn phần tiếng vọng còn sót; đeo tai nghe vẫn là cách triệt để nhất.
Câu hỏi thường gặp
Tại sao tôi nghe thấy giọng mình vọng lại trong cuộc gọi?
Thường do thiết bị của người bên kia: loa của họ phát giọng bạn, micro của họ thu lại và bộ khử vọng trên máy họ không khử hết. Hãy nhờ họ đeo tai nghe hoặc giảm loa.
Echo Cancellation có giống chống ồn (noise suppression) không?
Không. Khử vọng loại bỏ một tín hiệu mà máy biết trước (âm thanh chính nó phát ra loa). Chống ồn loại bỏ những âm thanh máy không biết trước như tiếng quạt, xe cộ, bàn phím. Hai khối thường chạy nối tiếp nhau trong cùng một chuỗi xử lý.
Tại sao chen ngang người khác thì giọng tôi bị nhỏ hoặc mất chữ?
Đó là tình huống double talk. Tầng hậu xử lý thấy có tiếng vọng nên hạ âm lượng micro xuống, vô tình bóp luôn giọng bạn. Thiết bị và phần mềm càng tốt thì hiện tượng này càng ít.
Đeo tai nghe rồi có cần Echo Cancellation nữa không?
Hầu như không còn tiếng vọng âm học, nhưng nhiều ứng dụng vẫn bật AEC vì tai nghe hở hoặc âm lượng lớn vẫn có thể rò một chút âm thanh vào micro. Bộ lọc khi đó gần như không có việc gì để làm và không gây hại.