Bạn nén một thư mục 1 GB, được file zip chỉ 400 MB. Gửi cho bạn bè, họ giải nén ra lại đúng 1 GB, mở từng file vẫn chạy ngon, không thiếu một chữ. Vậy 600 MB chênh lệch kia đã đi đâu? Nó không bị xoá, cũng không trốn trong một góc bí mật nào. Câu trả lời nằm ở một ý rất đơn giản: phần lớn dữ liệu máy tính đang lưu là sự lặp lại, và lặp lại thì có thể ghi gọn lại.
600 MB đó chưa từng là "thông tin thật"
Hãy tách hai khái niệm: dung lượng (số byte file chiếm trên ổ) và lượng thông tin (những gì thật sự cần để dựng lại file). Hai con số này hiếm khi bằng nhau.
Một file văn bản lặp đi lặp lại các từ "của", "và", "là"; một file log ghi hàng nghìn dòng gần giống hệt nhau, chỉ khác mấy con số thời gian; một file mã nguồn có hàng trăm chỗ viết function, return, const. Tất cả những phần lặp lại đó vẫn chiếm byte trên ổ, nhưng chúng dễ đoán. Mà cái gì dễ đoán thì không cần ghi ra đầy đủ.
Nén chính là nghệ thuật loại bỏ sự dư thừa này. Trong ví dụ 1 GB còn 400 MB, có thể hiểu là khoảng 400 MB là thông tin cốt lõi, còn 600 MB là phần lặp lại đã được thay bằng "công thức" ngắn gọn để tái tạo lại.
Ví dụ đơn giản nhất: 100 chữ A
Giả sử file chứa 100 chữ A liên tiếp. Mỗi ký tự ASCII tốn 1 byte, vậy file nặng 100 byte. Nhưng bạn hoàn toàn có thể mô tả nó bằng câu "100 lần chữ A", tức là ghi một con số đếm và một ký tự, chỉ vài byte. Khi giải nén, máy đọc quy tắc và viết lại đúng 100 chữ A, không sai một ký tự.
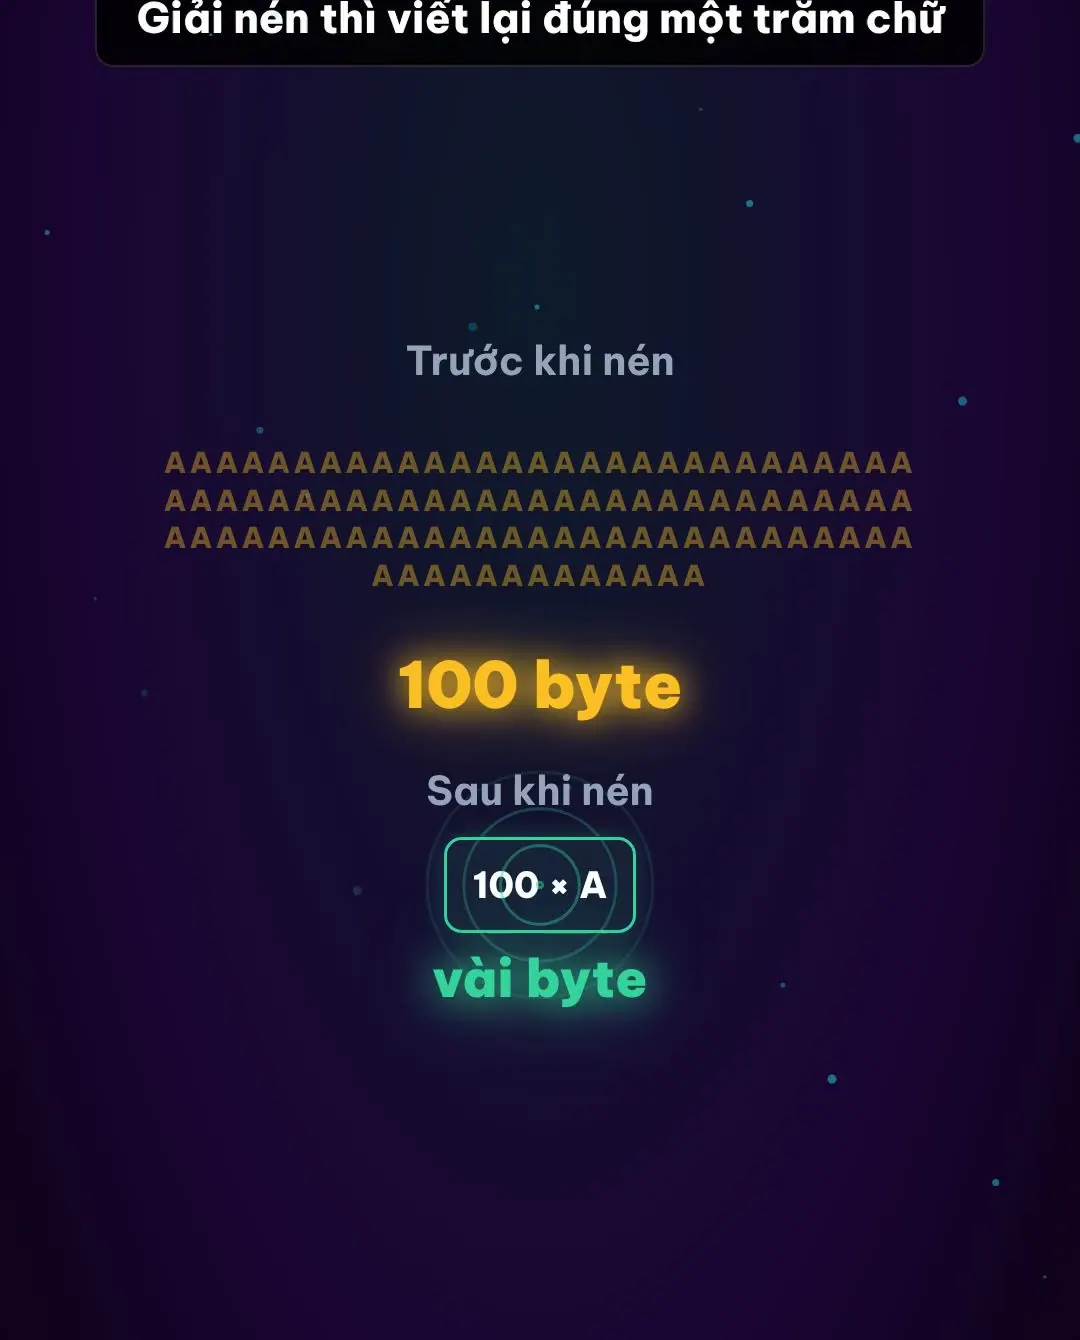
Kỹ thuật này gọi là mã hoá độ dài loạt (Run-Length Encoding, RLE). Nó cực hiệu quả với dữ liệu có nhiều "loạt" giống nhau đứng liền nhau, ví dụ ảnh có mảng màu trơn: thay vì ghi "trắng, trắng, trắng, trắng, trắng, trắng" thì ghi "6 trắng". Các định dạng ảnh đời đầu như BMP nén RLE hay PCX dùng đúng ý tưởng này.
Nhưng RLE có điểm yếu chí mạng: văn bản bình thường hiếm khi có ký tự lặp liền nhau. Chữ "con mèo" không có loạt nào để gom. Áp RLE lên văn bản thường còn có thể làm file to ra. Vì vậy cần cách thông minh hơn.
Deflate và LZ77: "quay lại bao nhiêu bước, chép bao nhiêu ký tự"
File .zip phổ biến nhất dùng thuật toán Deflate, do Phil Katz thiết kế cho PKZIP và sau đó được chuẩn hoá trong RFC 1951. Deflate cũng là thứ nằm bên trong gzip và ảnh PNG. Nó gồm hai bước chạy nối tiếp: LZ77 rồi mã Huffman.
LZ77 (đặt theo tên hai nhà khoa học Abraham Lempel, Jacob Ziv và năm công bố 1977) không đi tìm ký tự lặp liền nhau, mà tìm đoạn đã từng xuất hiện ở phía trước. Khi gặp lại một đoạn cũ, thay vì ghi lại nguyên văn, nó chỉ ghi một cặp số:
- Khoảng cách: lùi về sau bao nhiêu ký tự thì gặp đoạn trùng.
- Độ dài: chép bao nhiêu ký tự từ chỗ đó.
Lấy câu: "con mèo trèo cây cau, con mèo trèo cây cao". Nửa sau gần như trùng hoàn toàn với nửa đầu. Khi máy đọc tới chữ "con" thứ hai, nó nhận ra 19 ký tự "con mèo trèo cây ca" đã xuất hiện cách đó 22 ký tự. Vậy chỉ cần ghi [lùi 22, chép 19] rồi thêm chữ "o" cuối cùng.
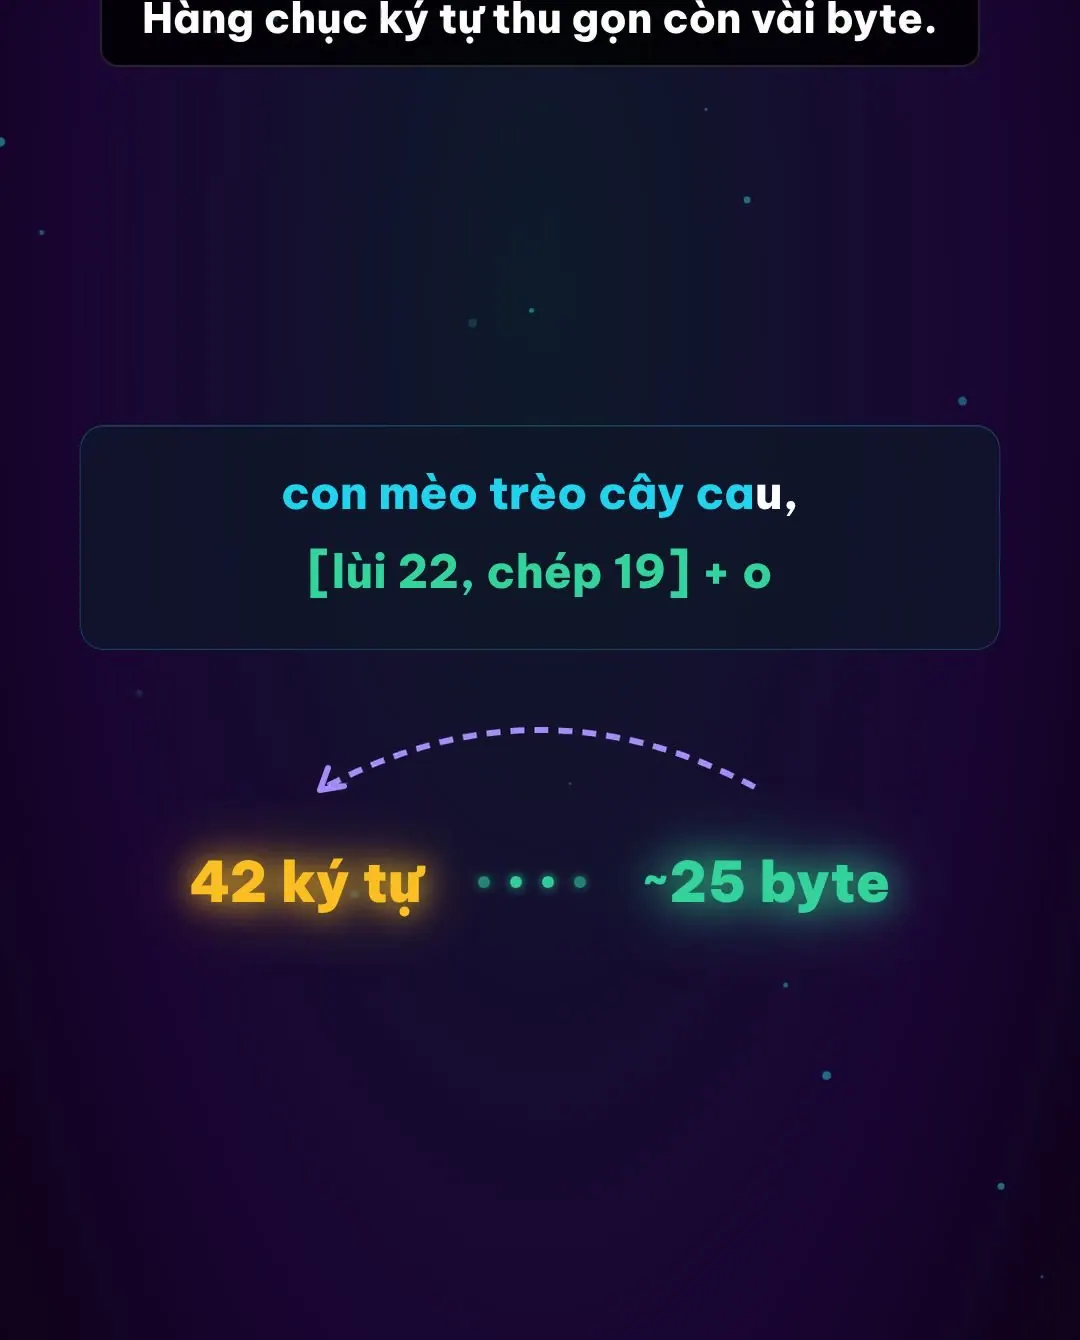
Trong Deflate, khoảng cách tối đa là 32 KB (gọi là "cửa sổ trượt") và mỗi đoạn chép dài từ 3 đến 258 byte. Nghe nhỏ, nhưng với văn bản, mã nguồn, HTML hay log, các đoạn lặp lại trong phạm vi 32 KB nhiều không đếm xuể.
Đoạn chép được phép "đè" lên chính nó. Ví dụ ghi A rồi [lùi 1, chép 99] sẽ ra đúng 100 chữ A. Nghĩa là LZ77 làm được luôn việc của RLE, nên Deflate không cần RLE riêng.
Mã Huffman: chữ hay dùng thì mã ngắn
Sau LZ77, dữ liệu là một chuỗi gồm ký tự đơn lẻ và các cặp (khoảng cách, độ dài). Bước hai là mã Huffman, do David Huffman công bố năm 1952, để ghi chuỗi này bằng ít bit nhất.
Bình thường mỗi ký tự tốn cố định 8 bit, dù là chữ "a" xuất hiện hàng nghìn lần hay chữ "z" chỉ xuất hiện hai lần. Huffman thống kê tần suất rồi phát mã có độ dài thay đổi: ký tự càng hay gặp thì mã càng ngắn (2–3 bit), ký tự hiếm thì mã dài hơn (có thể hơn 8 bit). Cộng lại, tổng số bit giảm rõ rệt.
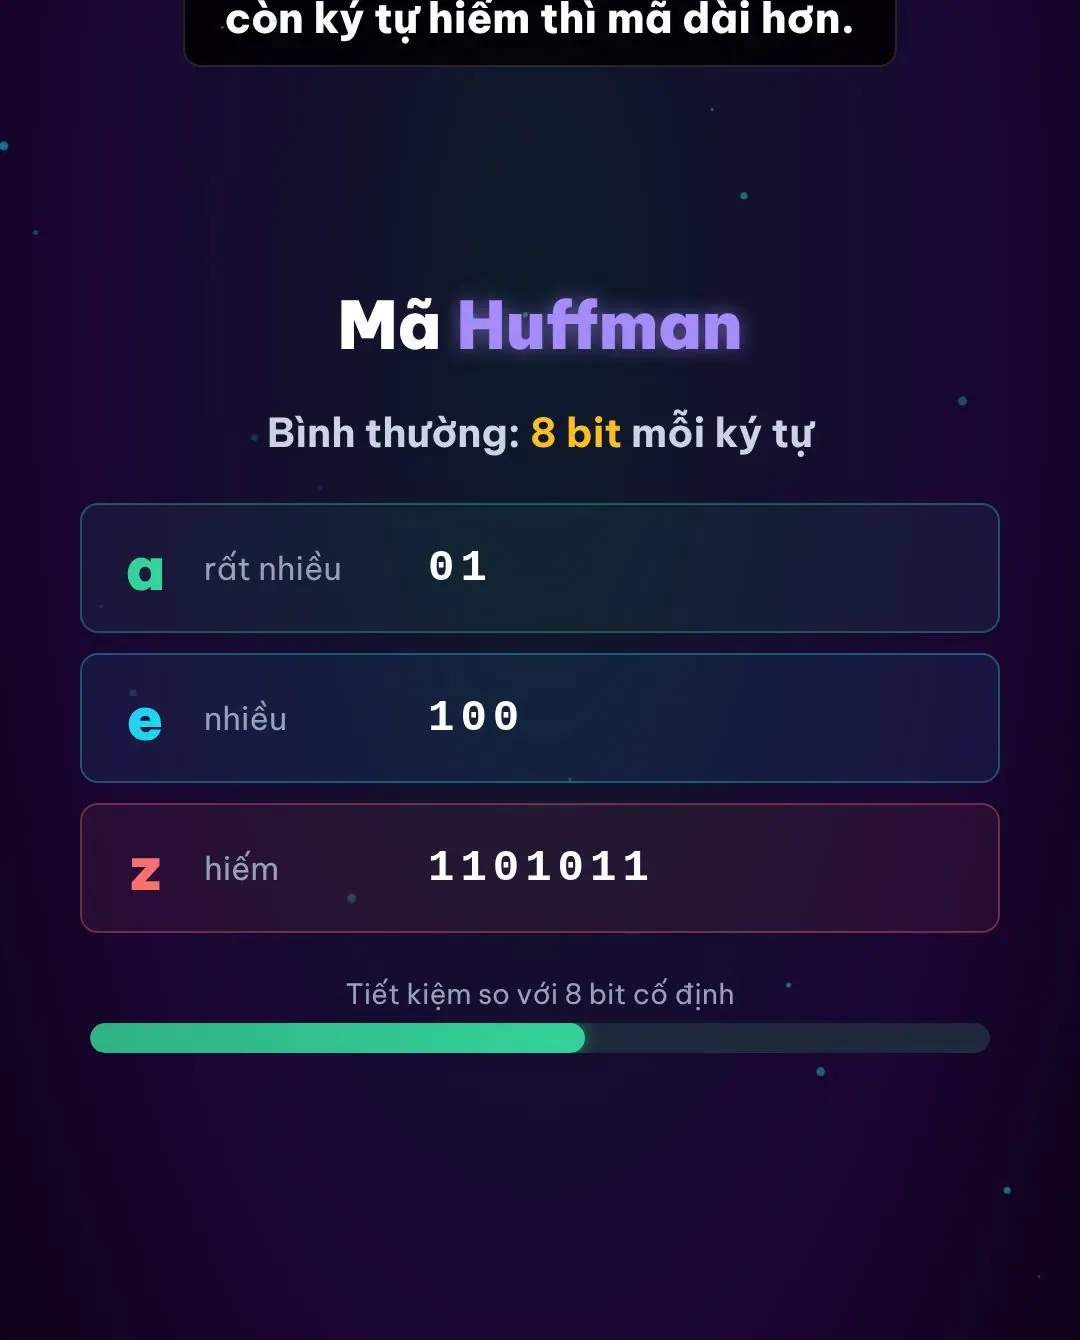
Hãy nghĩ tới cách bạn nhắn tin: "không" thành "k", "được" thành "đc", "bây giờ" thành "bh". Từ dùng càng nhiều thì viết tắt càng ngắn. Người nhận vẫn hiểu đúng vì hai bên dùng chung một bảng quy ước. Trong file zip, "bảng quy ước" này (cây Huffman) được lưu kèm ngay trong dữ liệu nén, nên máy giải nén luôn dịch ngược được chính xác.
Có một chi tiết làm Huffman không bị nhầm lẫn: không mã nào là phần đầu của mã khác (mã tiền tố). Nếu "a" là 01 thì không có ký tự nào có mã bắt đầu bằng 01. Nhờ vậy, đọc một dãy bit liền nhau, máy luôn biết chính xác chỗ nào kết thúc một ký tự.
Vì sao giải nén ra giống hệt từng bit?
Zip là nén không mất dữ liệu (lossless). Mọi phép thay thế ở trên đều có quy tắc đảo ngược duy nhất:
| Bước khi nén | Bước khi giải nén |
|---|---|
Thay đoạn lặp bằng [lùi X, chép Y] |
Lùi X ký tự, chép Y ký tự |
| Thay ký tự bằng mã Huffman | Tra cây Huffman để đổi mã về ký tự |
Gom loạt AAAA… |
Viết lại đúng số lần |
Không có bước nào "đoán" hay "làm tròn". Ngoài ra, mỗi file trong zip còn kèm một mã kiểm tra CRC-32 tính từ dữ liệu gốc. Khi giải nén, phần mềm tính lại CRC và so sánh; lệch một bit là báo lỗi ngay. Đó là lý do bạn tin được rằng file giải nén ra giống hệt bản gốc.
600 MB không biến mất. Nó được đổi thành công thức, và công thức đó luôn dựng lại đúng bản gốc.
Giới hạn tuyệt đối: entropy của Claude Shannon
Liệu có thể nén mãi, nén 1 GB còn 1 MB không? Câu trả lời đến từ nhà toán học Claude Shannon, người đặt nền móng cho lý thuyết thông tin trong bài báo "A Mathematical Theory of Communication" năm 1948.
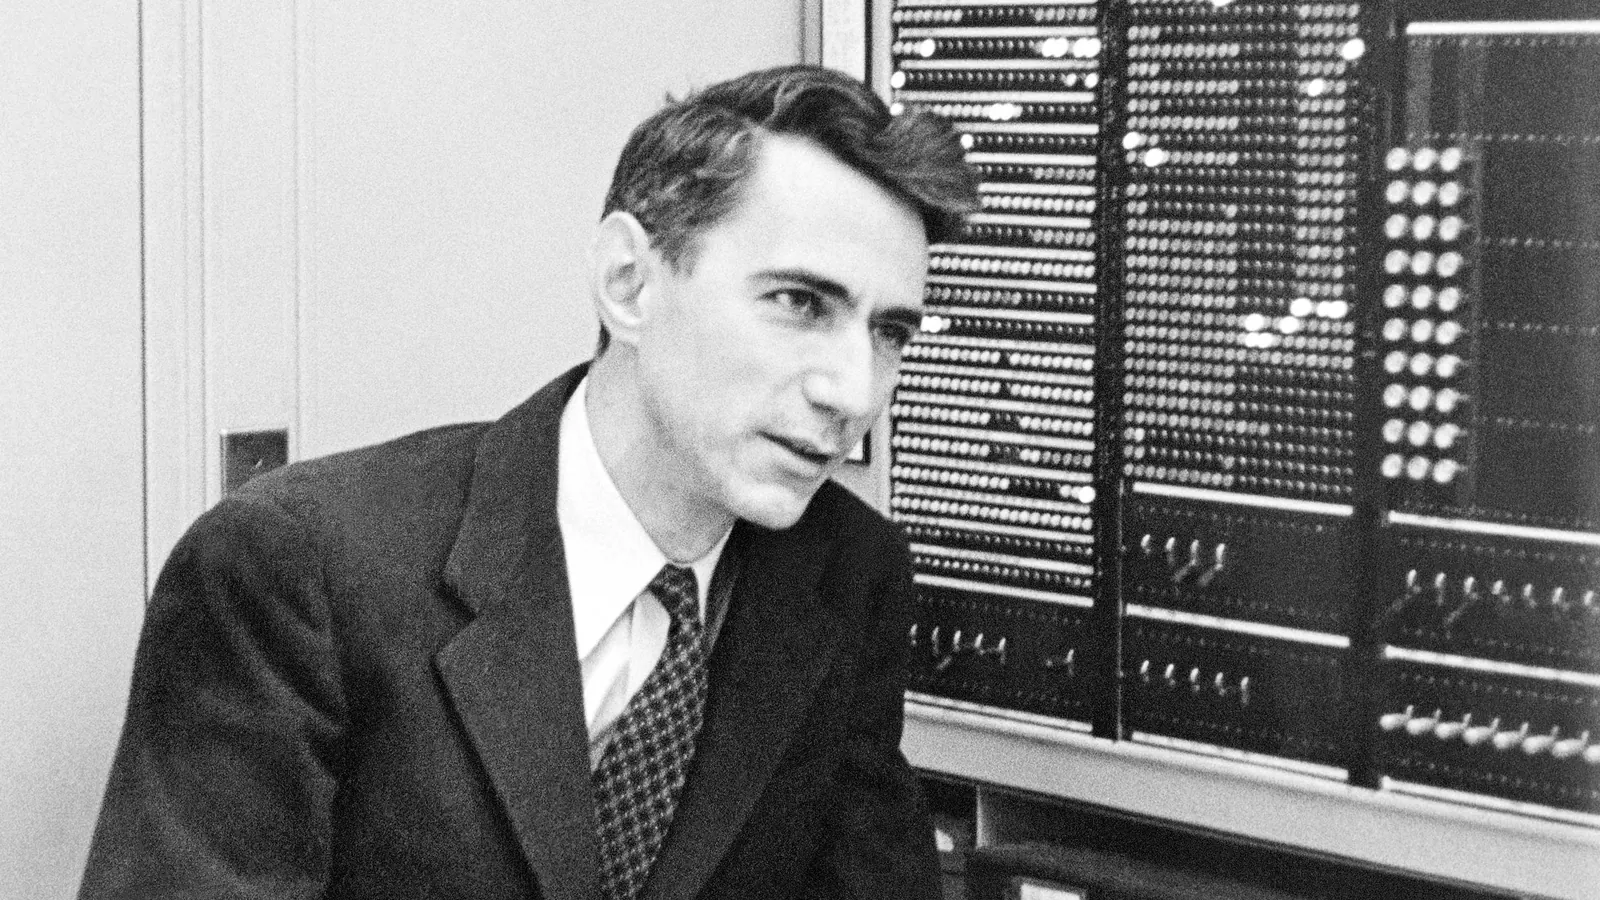
Shannon định nghĩa entropy là lượng thông tin thật trung bình trong dữ liệu, đo bằng bit. Dữ liệu càng dễ đoán, càng lặp lại thì entropy càng thấp, nén được càng nhiều. Dữ liệu càng ngẫu nhiên thì entropy càng cao. Không thuật toán nén không mất dữ liệu nào có thể (tính trung bình) nén xuống thấp hơn giới hạn entropy. Các thuật toán chỉ khác nhau ở chỗ tiến sát giới hạn đó đến đâu và tốn bao nhiêu thời gian.
Mỗi loại file nén được bao nhiêu?
Đây là phần nhiều người bất ngờ nhất: cùng là 1 GB, nhưng tỉ lệ nén khác nhau một trời một vực tuỳ loại file.
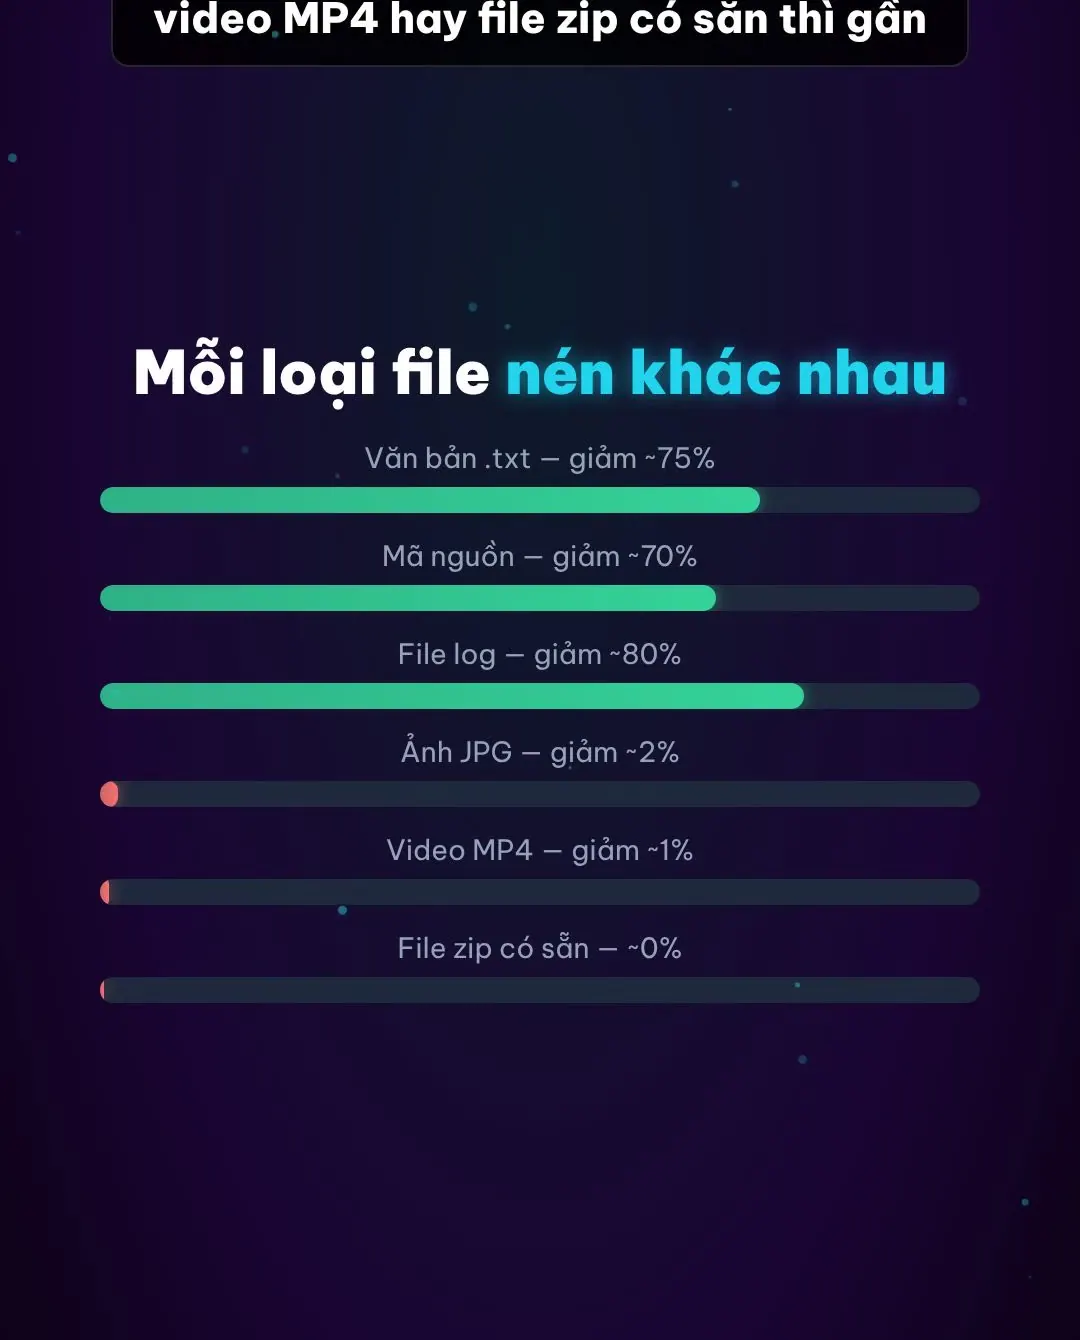
| Loại file | Mức giảm thường gặp khi zip | Lý do |
|---|---|---|
Văn bản .txt, CSV |
Khoảng 60–80% | Từ ngữ, cấu trúc lặp nhiều |
| Mã nguồn, HTML, JSON | Khoảng 70–80% | Từ khoá, thụt lề, thẻ lặp lại |
| File log | Có thể trên 80% | Dòng gần như giống hệt nhau |
File Word .docx, Excel .xlsx |
Rất ít | Bản chất đã là file zip |
| Ảnh JPG, PNG; video MP4; nhạc MP3 | Gần như 0% | Đã được nén từ trước |
| File zip, 7z, rar có sẵn | 0%, đôi khi to ra | Dư thừa đã bị ép hết |
Các con số trên mang tính tham khảo, phụ thuộc nội dung cụ thể và mức nén bạn chọn. Nhưng xu hướng thì luôn đúng: thư mục 1 GB toàn tài liệu, mã nguồn thì về 400 MB là bình thường; thư mục 1 GB toàn ảnh điện thoại và video thì nén xong vẫn gần 1 GB.
Lý do là JPG, MP4, MP3 đã dùng nén có mất dữ liệu (lossy): chúng bỏ bớt những chi tiết mắt hay tai người khó nhận ra, rồi nén phần còn lại rất chặt. Sự dư thừa đã bị vắt kiệt, kết quả trông gần như ngẫu nhiên, nên Deflate chẳng còn gì để ép.
Với thư mục toàn ảnh, video, hãy chọn chế độ "Store" (không nén, mức 0) trong 7-Zip hoặc WinRAR. Bạn vẫn gom được nhiều file vào một, nhưng nén xong nhanh hơn hẳn mà dung lượng gần như không khác.
Bạn có thể tự kiểm chứng trên Linux hoặc macOS:
zip -r tai-lieu.zip tai-lieu/     # nén thư mục, in % giảm của từng file
unzip -v tai-lieu.zip             # xem kích thước gốc, kích thước nén và tỉ lệ
gzip -l file.gz                   # xem tỉ lệ nén của file .gz
Không có thuật toán nào nén nhỏ được mọi file
Nghe vô lý nhưng đây là sự thật toán học, chứng minh bằng nguyên lý chuồng bồ câu: 5 con bồ câu mà chỉ có 4 ô chuồng thì chắc chắn có ô chứa 2 con.
Áp vào file: có đúng 2^n file khác nhau dài n bit, nhưng chỉ có 2^n − 1 file ngắn hơn n bit. Nếu một thuật toán nén mọi file n bit thành file ngắn hơn, chắc chắn có hai file khác nhau bị nén ra cùng một kết quả. Khi giải nén, máy không thể biết phải trả về file nào, tức là đã mất dữ liệu. Vậy với nén không mất dữ liệu, nếu có file nhỏ đi thì bắt buộc có file khác phải to ra (hoặc giữ nguyên).
Trong thực tế, zip xử lý tình huống này bằng cách lưu thẳng (store) những file không nén được, chỉ tốn thêm vài chục byte phần đầu file. Còn những ai quảng cáo "nén được mọi file xuống còn 10%" thì chắc chắn đang nói sai.
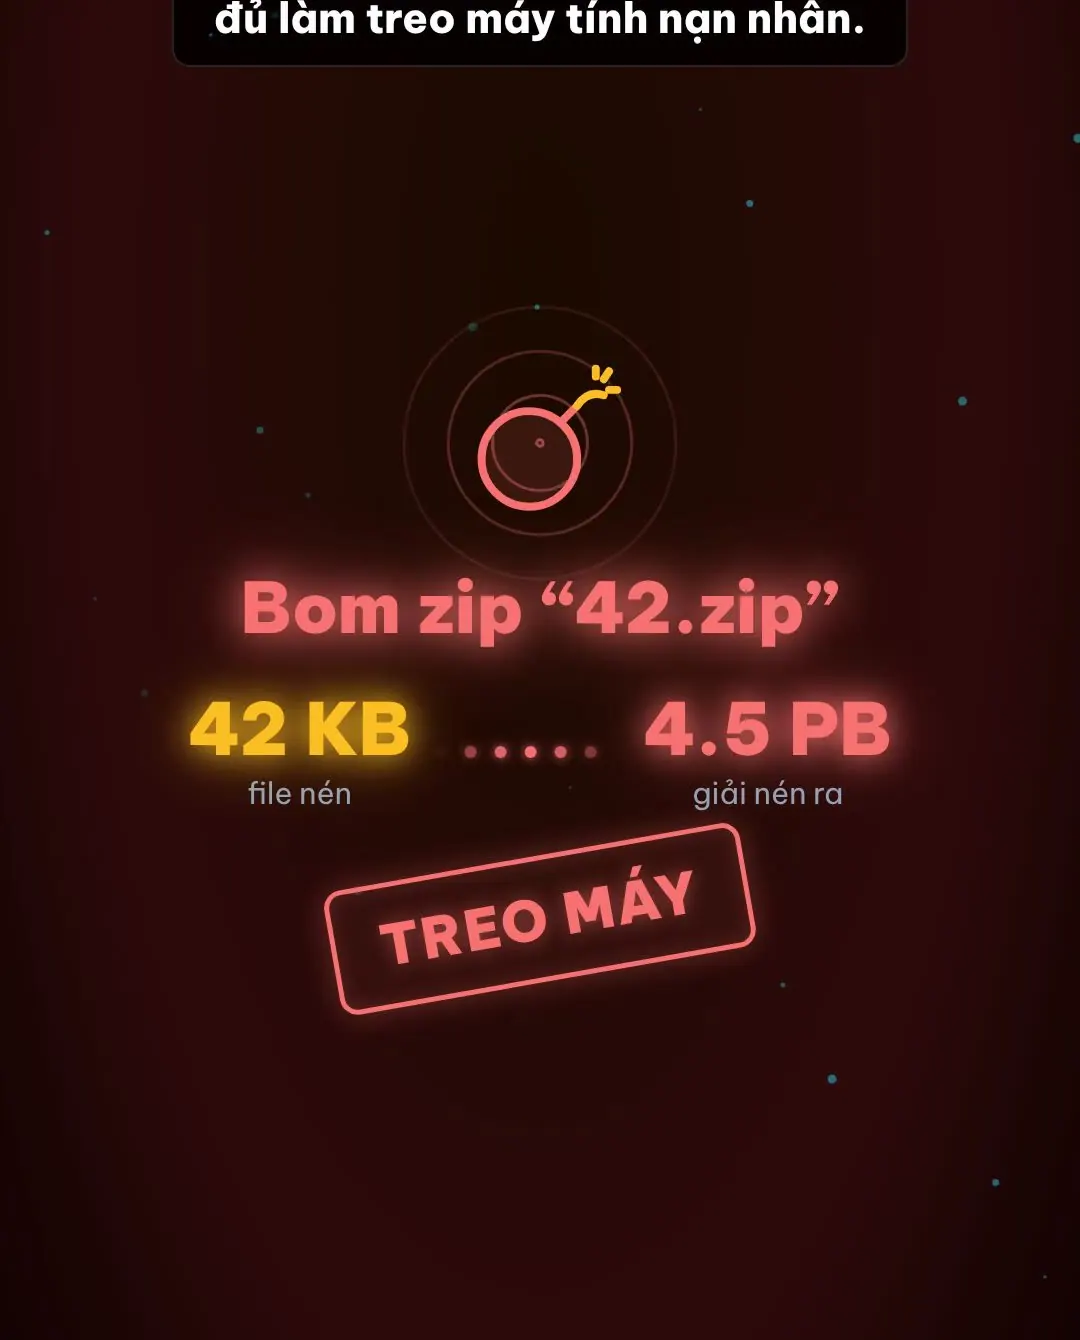
Ở chiều ngược lại, dữ liệu cực kỳ lặp lại có thể nén khủng khiếp. File 42.zip nổi tiếng chỉ nặng khoảng 42 KB nhưng chứa nhiều lớp zip lồng nhau, nếu giải nén hết sẽ ra khoảng 4,5 petabyte. Kẻ xấu dùng loại file này để làm treo máy, đầy ổ cứng hoặc làm sập phần mềm diệt virus. Đừng giải nén file lạ không rõ nguồn gốc, nhất là file zip nằm trong zip.
Cái giá của việc nén: đổi ổ cứng lấy CPU
Nén không miễn phí. Khi nén, máy phải dò tìm đoạn lặp trong cửa sổ 32 KB, thống kê tần suất, dựng cây Huffman. Khi giải nén, nó lại phải đọc công thức và dựng lại từng byte. Nói gọn: bạn đổi dung lượng ổ cứng và băng thông lấy công sức của CPU.
Vì vậy các phần mềm cho chọn mức nén. Mức cao tìm đoạn lặp kỹ hơn nên file nhỏ hơn một chút nhưng chậm hơn nhiều. Các định dạng mới như 7z (LZMA), Zstandard hay Brotli dùng cửa sổ lớn hơn và mô hình thống kê tinh vi hơn nên thường nén tốt hơn zip, đổi lại tốn RAM, CPU hơn hoặc kém tương thích hơn. Zip vẫn sống khoẻ vì máy nào cũng mở được mà không cần cài thêm gì.
Checklist khi cần nén một thư mục:
- [ ]Thư mục chủ yếu là tài liệu, mã nguồn: dùng zip mức chuẩn hoặc 7z để giảm nhiều.
- [ ]Chủ yếu là ảnh, video: dùng chế độ Store, đừng mất thời gian nén.
- [ ]Gửi cho người dùng phổ thông: ưu tiên
.zipđể ai cũng mở được. - [ ]File quan trọng: kiểm tra lại bằng tính năng "Test archive" trước khi xoá bản gốc.
Tóm tắt nhanh
- 600 MB "biến mất" chưa từng là thông tin thật, chỉ là phần lặp lại được ghi gọn thành công thức.
- Zip dùng Deflate: LZ77 thay đoạn lặp bằng cặp (lùi bao nhiêu, chép bao nhiêu), rồi Huffman cho ký tự hay gặp mã ngắn hơn.
- Mọi bước đều đảo ngược được và có CRC-32 kiểm tra, nên giải nén ra giống hệt từng bit.
- Văn bản, mã nguồn, log nén rất tốt; JPG, MP4, file zip có sẵn gần như không giảm.
- Không thuật toán nào nén nhỏ được mọi file, và không thể nén thấp hơn giới hạn entropy.
Câu hỏi thường gặp
Nén rồi giải nén nhiều lần có làm hỏng file không?
Không. Zip là nén không mất dữ liệu, nén và giải nén bao nhiêu lần thì dữ liệu vẫn giống hệt từng bit. Chỉ nén có mất dữ liệu như lưu lại JPG nhiều lần mới làm chất lượng giảm dần.
Nén file zip thêm một lần nữa có nhỏ hơn không?
Hầu như không, thậm chí to ra vài byte. Dữ liệu sau lần nén đầu gần như ngẫu nhiên, không còn dư thừa để ép.
Vì sao file Word, Excel nén zip gần như không giảm?
Vì .docx và .xlsx thực chất đã là file zip chứa các file XML. Bạn có thể đổi đuôi thành .zip rồi mở ra để xem.
Zip, 7z hay RAR nén tốt nhất?
Thường 7z (LZMA2) cho file nhỏ nhất, RAR xếp gần đó, zip kém hơn một chút nhưng tương thích tốt nhất. Mức chênh lệch lớn hay nhỏ phụ thuộc loại dữ liệu; với ảnh, video thì cả ba gần như như nhau.